Benchmarker’ler (test ölçütleri) yapay zekânın iki anlamda da hükümdarıdır. Ölçüm çubukları olarak son derece basit bir mantıkla çalışırlar: Bir AI modelinin ne yapabileceğini bilmek istiyorsanız, onu değerlendirecek standartlaştırılmış bir test icat edersiniz. Ancak AI benchmark’leri aynı zamanda alanın (sektörün) tamamının davranışını da yönlendirebilir.
1987’de Savunma İleri Araştır Projeleri Ajansı’nın (ilk benchmark’ı) otomatik konuşmadan metne çeviride, en gelişmiş yapay zekânin “aptal” istatistiksel yaklaşımlardan daha iyi sonuç veremediğini gösterdi. Düşük performans bir yapay zeka kışına kapı araladı. 25 yıl boyunca yapay zeka araştırmalarına olan ilgi azaldı ve finansman kurudu.

Ardından, 2012’de başka bir benchmark olan ImageNet sarkacı geri çevirdi. Sekiz katmanlı bir sinir ağı, görüntüleri sınıflandırmada diğer algoritmaları yendi ve bir “derin öğrenme devrimi’nin kapısını araladı.
Günümüzde, OpenAI‘ın GPT-6 Astra’sı gibi büyük dil modellerine yönelik yeni AI benchmark’ları saat gibi düzenli biçimde oluşturuluyor ve çözülüyor; alanına özgü uzmanlık ile “genel zeka” arasındakilerin tümünü ölçtüğünü iddia ediyorlar. Ancak bu eğilim, yapay zekânın gökyüzüne çıkan potansiyeline dair kanıt olarak kutlanmak yerine, alan içindeki birçok kişi — şüpheçiler ile savunucular — bunun benchmarking’in (ölçümleştirmenin) kendisinin ölümcül biçimde kusurlu hale geldiğine dair kanıt olduğunu düşünüyor.
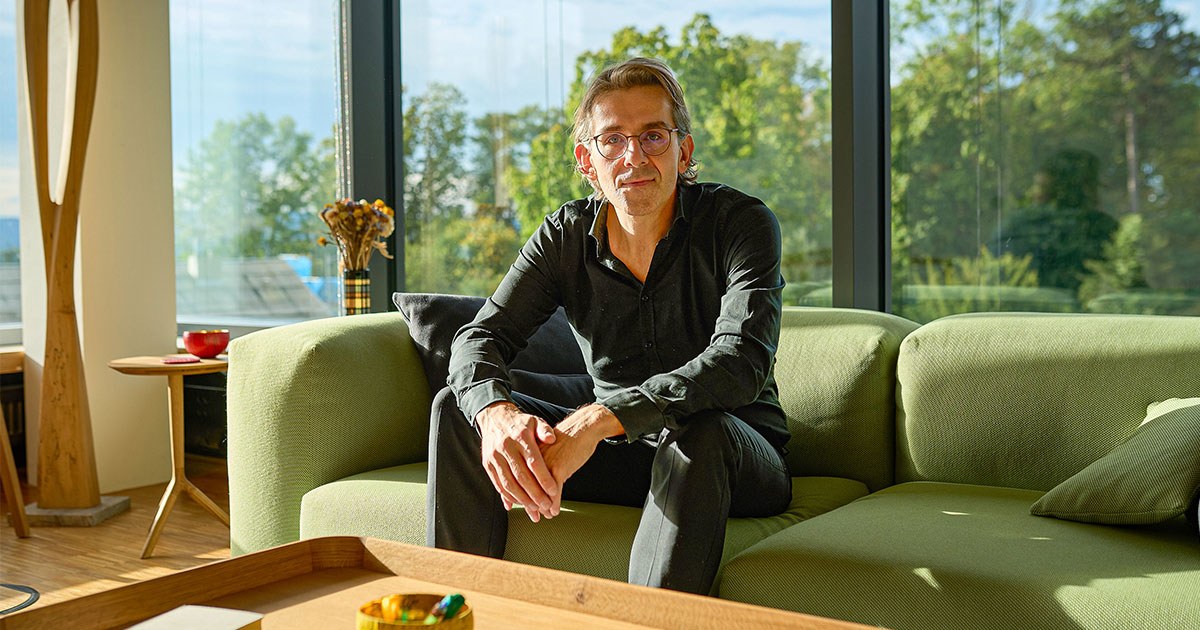
Bilgisayar bilimci ve Max Planck Akıllı Sistemler Enstitüsü’nde bir direktör olan Moritz Hardt, bu tanıya katılıyor. ImageNet sonucundan kısa bir süre sonra, makine öğrenmesi sistemlerinin lider tablolarını “hiçbir akıllı şey yapmadan” manipüle edebileceğini düşünmeye başladı. “Bunun için iki yol yok,” dedi. “Benchmarking ekosistemi bozuk.”
2026 tarihli Makine Öğrenmesi Benchmark’larının Belirgen Bilimi adlı kitabında Hardt, bu ölçüm çubuklarının zaten onlarca yıldır bozuk olduğu iddiasıyla sarsıcı bir savunma sunar: Benchmark’ler, yazdığı gibi, “makine öğrenmesini yaratan hatadır.” Önemlisi, meşru ilerlemeye engel olmak yerine bunun tersini yaptıkları iddiasıdır — ona göre bu, “çoğuyla sırf şans sayesinde” gerçekleşti. Neden böyle olduğunu anlayarak, benchmark’lerin dil modelleri (LLM) çağında nasıl o tesadüfi güvenilirliğini kaybettiğini ve bunu nasıl geri kazanabileceklerini açıklayabiliriz.
Quanta , Hardt ile benchmark’larda neyin yanlış gittiğini, neyin doğru olduğunu ve bunların gelecekte nereye götürüleceğini konuştuk. Röportaj netlik amacıyla kısaltılmış ve düzenlenmiştir.




1 kommentar
Udbyg din idé med en kilde, spørgsmål eller konstruktivt modargument.