Özet
İmaja imej çevirme, imej gürültüden arındırma ve çoklu modallık sentezi dahil olmak üzere tıbbi imej uygulamalarında güçlü bir teknikle öne çıkmıştır. Ancak, önceden eğitilmiş çevirim modelleri, test örnekleri eğitim sırasında gözlemlenen kaynak-alan verilerinden farklılaştığında performans düşüklüğü gösterebilir. Örnek bilinçli Bir-Zaman-Uyumlanması çerçevesini öneriyoruz; bu çerçeve, her test örneğinin uyumlanması gerekip gerekmediğini ve nasıl uyumlanacağını dinamik olarak belirler. Çerçeve, kaynak-alan temsilleriyle uyum ölçen Bir Yeniden Kurulum Modülü ile donuklaştırılmış bir çevirim modelinin iç özellik seviyelerini seçici olarak değiştiren Bir Dinamik Uyumlanma Bloğu’nu birleştirir. Çıkış yeniden kurulum hatası, uyumlanmayı tetiklemek ve hafif özellik seviyesi uyumlayıcılarının örnek bazında seçimi ve optimizasyonunu yönlendirmek için kullanılır. Önerilen yaklaşım, düşük doz CT gürültüden arındırma ve T1’den T2’ye MR imej çevirmesi üzerinde kaynak-alan, anatomik kayma ve dış-alan koşulları altında değerlendirilmiştir. Önerilen yöntem, anatomik ve dış-alan kaymaları altında imej çevirme kalitesini artırırken, uyumlamanın ölçülebilir bir fayda sağlamadığı baskın olarak dağılım içi ortamda donuklaştırılmış görev modeliyle karşılaştırılabilir kalmaktadır. Sonuçlarımız, seçici aktivasyonun örnek bazında uyumlayıcı seçimiyle birleştirilmesinin, test örneklerine üzerinde sabit bir uyumlanma prosedürünün uniform olarak uygulanmasından daha güvenilir bir strateji sağladığını göstermektedir. Kod şurada mevcuttur: https://github.com/arco-group/Sample-Aware-TTA.
1 Giriş
İmajdan imaja çeviri, bir resmi kaynak alanı X‘den hedef alanı Y‘ye eşler (Pang et al., 2021). Tıbbi görüntülemede gürültü giderme, modallar arası sentez, üst-çözünürlük ve uzunlamasına görüntü tahmini gibi görevleri destekler (Kaji ve Kida, 2019; Mantegna et al., 2026). Klinik ortamlarda imajdan imaja çeviri, tekrarlı kazanımların ihtiyacını azaltabileceği ve radyasyon tabanlı görüntülemede hastalara maruz kalmanın sınırlandırılabileceği için önemli ölçüde zaman ve maliyet avantajı sunabilir. Ancak bu modellerin performansı, tarayıcılar, kazanıım protokolleri, hasta popülasyonları veya anatomik bölgelerdeki farklılıklardan kaynaklanan dağılım kayması altında bozabilir (Hognon et al., 2024). Böyle kaymalar, eğitim dağılımından sapan örnekler olan dağılım dışı (OOD) verilere yol açar; bu da model performansını düşürür, genelleşmeyi sınırlar ve daha düşük kaliteli çeviriler üretir.
Sınav Zamanında Uyum (TTA), dağılım kaymasını, önceden eğitilmiş bir modeli eğitim sırasında yeniden eğitmeden, çıkarım sırasında uyumlayarak giderir (Liang et al., 2025; Wang et al., 2025). Bu ortam, tıbbi görüntülemede hedef alanı etiketlerinin mevcut olmadığı ve model eğitimini tekrar etmenin pratik olmadığı durumlarda önem taşır.

Tıbbi görüntülemedeki TTA yöntemlerinin çoğu, görüntü sınıflandırma (Ma et al., 2022; Yang et al., 2022; Wang et al., 2021) ve semantik segmentasyon (Karani et al., 2021; Li et al., 2022; Valvano et al., 2022; Wen et al., 2024; Hu et al., 2021) dahil ayırt edici görevler için geliştirilmiştir. Bu yöntemler çıkarım sırasında girdi temsillerini, seçili model parametrelerini, normalleştirme istatistiklerini veya optimizasyon programlarını uyumlandırır. Amaçları sınıf olasılıkları veya segmentasyon maskeleri için tanımlanır ve doğrudan imajdan imaja çeviriye aktarılamaz. Üretimsi görevlerde uyum, alan kayması altında imaj kalitesini artırırken anatomik içeriği korumalı ve dağılım içi (ID) örneklerin gereksiz biçimde değiştirilmesinden kaçınmalıdır (Molino et al., 2026).
Ayrıca, mevcut TTA stratejilerinin çoğu, uyduranma işlemini OOD ya da ID olmalarından bağımsız olarak, yani eğitim kümesinin dağılımıyla aynı dağılımdan elde edilmiş olsun olmasın, tüm test örneklerine uygular. Bu kritik bir sınırlamadır çünkü ID verisine TTA uygulamak modelin en iyi yapılandırmasını bozabilir ve genelleşmesini zayıflatabilir (Niu ve ark., 2022). Bu nedenle, kaymış örneklere uyduranma ile modelin özgün bilgisini koruma arasında doğru dengeyi kurmak, çeşitli veri dağılımları boyunca tutarlı ve güvenilir performans elde etmek için büyük önem taşır.
Bu gerekçelerle, önceden eğitilmiş bir görüntüden görüntüye çeviri modelini dağılım kayması altında dinamik olarak uyduranırken, kaynak benzeri verilerdeki performansını koruyan, örneğe duyarlı bir TTA yöntemi öneriyoruz. Bu amaçla, her bir test girdisi için alan kaymasının derecesini nicelendiren, eğitilebilir bir yeniden inşâ modülü tanımlıyoruz ve tahmin edilen kaymaya dayanarak bir uyduranma modülü, çeviri modelinin birden fazla aşamasında girdi- ve özellik düzeyinde dönüşümler uygulayarak her bir test örneğinin özgün özelliklerine uyum sağlıyor.
Yöntemimizi iki ayrı görev üzerinde deneylerle doğruluyoruz: düşük dozlu BT gürültü giderme (LDCT) ve T1’den T2’ye MR görüntüleri çevirisi.
Katkılarımız şöyle özetlenebilir:
-
Önceden eğitilmiş bir görüntüden görüntüye çeviri modelini dağılım kayması altında uyduranan, kaynak alanında ve kaymış alanda veri arasındaki performans açığını etkili biçimde daraltırken, kaynak alanında performansı koruyan örneğe duyarlı bir TTA çerçevesi öneriyoruz.
-
Kaynak alanında ve kaymış alanda veri arasındaki performans açığını daraltmak için, tetikleyiciyle seçilen her bir test örneğine göre uyduranması gereken özellik düzeylerini tahmin edilen dağılım kaymasına göre seçen dinamik, örneğe özgü bir TTA stratejisi tasarlıyoruz.
-
Çerçeveyi düşük dozlu BT gürültü giderme ve kaynak alanında, anatomik kayma ve dış alan koşulları altında modeller arası MR görüntüleri çevirisi üzerinde değerlendiriyoruz.
Makalenin geri kalanı şu şekilde düzenlenmiştir. 2 bölümünde TTA ile ilgili çalışmalar incelenmekte, 3 önerilen çerçeveyi sunmakta, 4 deneysel kurulumu açıklamakta, 5 sonuçları sunup tartışmakta, 6 ise sonuç bölümünde kapanış değerlendirmelerini içermektedir.
2 İlgili çalışmalar
TTA, dağılım kaymaları altında sağlamlığı artırmak amacıyla geniş ölçüde incelenmiştir (Liang et al., 2025; Wang et al., 2025). Tıbbi görüntülemede mevcut yaklaşımlar çoğunlukla ayırt edici görevlere odaklanmıştır. Sınıflandırma için TENT (Wang et al., 2021), Ma et al. (2022) ve DLTTA (Yang et al., 2022) gibi yöntemler çıkarım sırasında normalleştirme istatistiklerini, sınıflandırıcı çıktılarını veya öğrenme dinamiklerini uyarlamaktadır. Segmentasyon için Karani et al. (2021), segmentasyon maskeleri üzerinde bir otomatik kodlayıcı öncülüyle yönlendirilen giriş düzeyinde uyarlama sunmuş, ardından gelen çalışmalar bu fikri saldırgan öncüller (Valvano et al., 2022), özellik düzeyinde uyarlama (Li et al., 2022), gürültü giderme hedefleri (Wen et al., 2024) veya toplu normalleştirme güncellemeleri (Hu et al., 2021) kullanarak genişletmiştir.
Bu yöntemler öngörücü görevler için etkili olsa da, doğrudan üretici görüntüden görüntüye çeviri için tasarlanmamıştır. Optimizasyon hedefleri etiketler veya segmentasyon maskeleri gibi ayrık veya yapısal tahminlere bağlıyken, görüntü çevirisi anatomik sadakati koruyan, ID örnekleri üzerinde gereksiz değişikliklerden kaçınan ve dağılım kayması altında görüntü kalitesini artıran bir hedef alan görüntüsü sentezlemeyi gerektirir.
Empirik karşılaştırmayı tanımlarken, test-zamanı amacının sürekli görüntü değerli çıktılar için somutlabileceği, önceden eğitilmiş görev modeline kaynak-alan eğitim süreci değiştirilmeden sonradan uygulanabildiği ve aynı uyarlama protokolünün hem LDCT gürültü giderme hem de modallar arası MRI çevirisinde kullanılabileceği bir TTA yöntemi göz önüne aldık. Bu kriterler, sınıf olasılığı çıktıları gerektiren amaçlarıyla entropi ve sınıf dağılımı temelli yaklaşımların doğrudan uygulanmasını engeller. DLTTA (Yang ve ark., 2022) otonom bir uyarlama yöntemi değildir; çünkü amacı kendisi tanımlamak yerine, altta görev-specifik bir TTA amacının öğrenme hızını düzenler. Maske öncillerine, kontur kayıplarına veya birlikte eğitilen yardımcı dallara dayanan segmentasyon odaklı yaklaşımlar, hem mimari hem de orijinal eğitim sürecinde kapsamlı değişiklikler gerektirir. Ayrıca normalizasyon temelli yaklaşımlar, istatistik koşulu olmadan non-affine Instance Normalization kullanan ve bu yaklaşımların gerektirdiği normalizasyon parametrelerini veya parti istatistiklerini ortaya çıkarmayan önceden eğitilmiş CycleGAN’ımızda (Zhu ve ark., 2017) doğrudan somutlabilmez.
Karlaştırmayı özgün olarak görüntü çevirisi için geliştirilen yöntemlerin ötesine taşımak amacıyla, temel uyarlama ilkeleri altta yatan amacın yeniden tanımlanmadan sürekli çıktılara aktarılabileceği iki jeneratif olmayan yaklaşımı dahil ettik. İlk olarak, Karani ve ark.’nın (2021) giriş düzeyindeki uyarlama mekanizmasını koruyup segmentasyon maske öncisini bir çıktı-alanı yeniden inşası öncisiyle değiştirerek uyarladık. Bu rakip, yalnızca giriş temsilinin değiştirilmesinin jeneratif tıp görüntülemesindeki dağılım kaymasının telafi edilmesi için yeterli olup olmadığını değerlendirir.
İkinci olarak, hem sınıflandırma hem de regresyon çıktılarını destekleyecek şekilde tasarlanmış, çok yönlü bir kendi kendine bootstrap (self-bootstrapping) yöntemi olan SPA (Niu ve ark., 2025)’yı değerlendiriyoruz. SPA (Niu ve ark., 2025), modeli, orijinal test görüntüsünden elde edilen tahmin ile aynı görüntünün bozulmuş bir görünümünden elde edilen tahmin arasında tutarlılık zorunlu kilarak uyarlar. Biz bu ilkeyi görüntüden görüntüye çevirme işine uygulayarak, test girdisine Gauss gürültüsü yoluyla bozulma uyguluyor ve karşılık gelen çevirmeler arasında bir ℓ1 tutarlılık kaybını minimize ediyoruz.
Bildiğimiz kadarıyla, He ve ark. (2021), TTA için tıbbi görüntüden görüntüye çevirme işini doğrudan ele alan tek önceki çalışmadır. Yöntemleri, özyineleme kaybyla (autoencoder tabanlı yeniden inşaa kaybı) yönlendirilen sığ adaptör ağları kullanarak özellik düzeyinde uyarlama gerçekleştirir. Ancak uyarlama, tüm test örneklerine eşit şekilde uygulanır ve sabit bir adaptör yapılandırmasına dayanır; ID ve OOD girdileri arasında ayrım yapmadan, uyarlanan özellik düzeylerini ise bireysel örneklerin her birine göre uyarlamadan.
Bu farkları açıklamak için Tablo 1, temsilci TTA yaklaşımlarını hedef görev, uyarlama tetikleyicisi, uarlanan bileşen, optimizasyon amacı ve halka açık kod erişilebilirliğine göre özetlemektedir. Tablo aynı zamanda deneysel değerlendirmemizde göz önüne alınan rakiplerin seçimini de gerekçelendiriyor. Birlikte Karani ve ark. (2021), SPA (Niu ve ark., 2025) ve He ve ark. (2021), sırasıyla girdi düzeyinde uyarlama, kendi kendine bootstrap modeli uyarlama ve sabit özellik düzeyinde uyarlama ile tamamlayıcı karşılaştırmalar sağlamaktadır.
| Yöntem | Uyarlanma tetikleyicisi | Uyarlanan bileşen | Optimizasyon amacı | Kod |
|---|---|---|---|---|
| ■Wang ve ark. (2021) | Tüm örnekler | Normalleştirme parametreleri | Entropi minimize etme | |
| ■Ma ve ark. (2022) | Etiket kayması tahmini | Toplu çıktılar | Tutarlılık düzenlemesi | |
| ■▴Yang ve ark. (2022) | Kayma bilinçli LR | Model parametreleri | Görev özelinde test-zamanı kaybı | |
| ▴Karani ve ark. (2021) | Tüm örnekler | Girdi normalleştirme ağı | Bölütleme maskelerine dayalı AE önceliği | |
| ▴Valvano ve ark. (2022) | Tüm örnekler | Girdi normalleştirme ağı | Saldırgan maskeli öncelik | |
| ▴Li ve ark. (2022) | Tüm örnekler | Girdi ve özellikler | İnşa rehberli bölütlememe kaybı | ✗ |
| ▴Wen ve ark. (2024) | Tüm örnekler | BN katmanları | Kendi kendine denetlenen gürültü temizleme kaybı | |
| ▴Hu ve ark. (2021) | Tüm örnekler | BN parametreleri | İkon ve kontur düzenlemesi | ✗ |
| ■▴Niu ve ark. (2025) | İkon bilinçli seçim | Görev modeli parametreleri | Zayıftan güçlüye tutarlılık | |
| He ve ark. (2021) | Tüm örnekler | Sabit sığ uyarlayıcılar | AE inşa kaybı | |
| Bizimkiler | İnşa hatası | İnşa hatasına göre dinamik olarak seçilen uyarlayıcılar | İnşa rehberli optimizasyon |
Yöntemler, İlgili Çalışmalar bölümünde tartışıldığı sırayla verilmiştir. Görev kategorileri sembollerle gösterilir: ■Sınıflandırma, ▴Bölütleme ve görüntüden görüntüye çevirme. BN toplu normalleştirmeyi, AE ise otomatik kodlayıcıyı ifade eder. Kalın metin, önerilen yöntemi ve buna karşılık gelen özellikleri belirtir.
3 Yöntemler
x ∈ ℝw×h kaynak görüntüsü ve buna karşılık gelen hedef görüntüsü y ∈ ℝw×h olarak tanımlansın; burada w ve h sırasıyla görüntünün genişliğini ve yüksekliğini belirtir. Görüntüden görüntüye çeviri şu şekilde formüle edilebilir:
Eşitlik 1’de, kaynak görüntüsünü x karşılık gelen hedef sürümüne dönüştürecek şekilde eğitilen genel görev modeli f gösterilmektedir. Çıkarım sırasında, dağılım kaymasından olası etkilenen örneklerde görev modelinin performansını iyileştirmek için TTA uygularız. Amaç, modeli birebir örnek test örneğine uyarlayarak çeviri hatasını azaltmaktır, böylece:
Eşitlik 2’de, y TTA uygulandıktan sonra sentezlenen çıktıyı; |·| ise genel bir hata ölçüsünü (örneğin ℓ1 veya ℓ2 normu) göstermektedir. Açıklık açısından, makalede kullanılan gösterimler Tablo 2’de listelenmiştir.
| Simge | Açıklama |
|---|---|
| Ax | Giriliş düzeyinde uyarlayıcı |
| Ai | Orta düzeydeki uyarlayıcıların kümesi |
| hi | i. katmanın özellik haritaları |
| i. katmanın uyarlanmış özellik haritaları | |
| i. düzeyde kodlayıcı ve kod çözücü özellik haritalarının birleştirilmesi, şu şekilde tanımlanır | |
| M | TTA sırasında uyarlayıcıları güncellemek için kullanılan eğitim adım sayısı |
| n | Görev modelindeki katman sayısı |
| Resimden resme çeviri için kullanılan görev modeli | |
| ω tarafından tanımlanan konumlara uyarlayıcılar yerleştirilmiş görev modeli | |
| x | Kaynak görüntü |
| xa | TTA uygulandıktan sonraki giriş |
| y | Hedef görüntü |
| Sentezlenen hedef görüntü | |
| TTA hattının tümünün sentezlediği çıktı | |
| Giriş alanında yeniden inşa modeli | |
| Çıkış alanında yeniden inşa modeli | |
| ϵx | Uyarlanmış girişteki yeniden inşa hatası, |
| ϵi | i. düzeydeki orta özelliklerde yeniden inşa hatası |
| ϵy | Çıkıştaki yeniden inşa hatası, |
| τ | Uyarlamayı tetikleyen eşik değeri |
| Ω | Yeniden inşa yapılandırmalarının arama alanı |
| ω | Ω içinde aday bir yapılandırma |
Tıbbi görüntüden görüntüye çeviri için sunduğumuz TTA çerçevesi Şekil 1’de gösterilmektedir. (a) paneli, yaklaşımımızın dört ana bileşenden oluştuğunu ortaya koyar: ilki, adaptasyon sırasında dondurulan önceden eğitilmiş görev modelidir. İkincisi, yalnızca yüksek çıkış yeniden yapılandırma hatasına sahip örneklerde adaptasyonu seçici olarak aktive eden TTA tetikleyicisidir. Üçüncüsü, (b) panelinde gösterilen ve çoklu özellik seviyelerinde alan kaymasını tahmin ederek adaptasyon sürecini yönlendiren Yeniden Yapılandırma Modülü’dür (RM). Dördüncü bileşen ise, giriş özelliklerini RM tarafından tahmin edilen kaymaya göre dönüştüren Dinamik Adaptasyon Bloğu’dur (DAB) (c paneli). Yaklaşımımızın temel fikri, yalnızca gerektiğinde ve örnek başına bir biçimde adaptasyon yapmaktır. Bir yandan, gereksiz adaptasyondan kaçınmak için tetiklenmeyen örnekler için sabit parametreleri koruruz. Diğer yandan, tetikleyici tarafından seçilen örnekler için özellik seviyesinde adaptasyonu, en etkili özellik dönüştürücü alt kümesini dinamik olarak seçerek etkinleştiririz.
Bu amaçla, çok adımlı bir eğitim süreci izleriz. Öncelikle görev modelini eğitiriz; ardından modelini dondurur ve RM’yi aynı eğitim kümesi üzerinde, farklı seviyelerde özellik dağılımlarını öğrenmek ve yeniden yapılandırma hatalarını nicelendirmek için eğitiriz; bu da TTA sırasında alan kayması için bir gösterge görevi görür. Şekil 1a’ya uygun olarak, test görüntüsü önce dondurulmuş modele gönderilir ve çıkış görüntüsü elde edilir. Ardından, görev modelinin çıkışı ile yeniden yapılandırması arasındaki farkı hesaplamak için yeniden yapılandırıcıyı kullanırız:
Bir tetikleyici mekanizma, TTA’ı, denklem 3 kullanılarak hesaplanan çıktı yeniden inşâ hatası bir eşik değeri τ’yu aştığında aktive eder. Bu kriteri sağlayan örnekler tetikleyici-seçili örnekler olarak adlandırılır. TTA tetiklendikten sonra, x görüntüsü, RM’den alınan yeniden inşâ hatasını kullanarak giriş düzeyinde uyumlamayı yapan DAB modülü tarafından işlenir ve uyumlanmış bir giriş xa üretir. Uyumlanmış giriş xa ardından f1 özellik haritasını üretmek üzere g‘nin ilk katmanından geçirilir. DAB, f1‘yi uyumlanmış karşılığı ḟ1‘ye dönüştürür; bu da f1‘nin yerini alır ve g‘nin bir sonr katmanına aktarılır. Uyumlama ve ileri yayılımın bu yinelemeli süreci katman katman sürerek nihayetinde uyumlanmış son çıktuyu ŷa üretir. Aşağıda, 3.1 ve 3.3 sırasıyla Yeniden İnşâ Modülü (RM) ve Dinamik Uyumlama Bloğu (DAB)’nu detaylandırır.
3.1 Yeniden İnşâ Modülü (RM)
Şekil 1b’de gösterilen Yeniden İnşâ Modülü (RM), hem görev modeli g içindeki ara özellik haritalarında hem de oluşturulan çıktıda yeniden inşâ hataları hesaplayarak alan kaymasını nicelendirir. Bu amaçla, g‘nin her katmanı, RM içinde bir konvolüsyonel otomatik kodlayıcı olarak uygulanan ayrı bir yeniden inşâ ağı eşleştirilir. Bu ağlar g̃1, g̃2 ve g̃3, g‘yi eğitmek için kullanılan aynı veri üzerinde bağımsız olarak eğitilir ve kendi düzeylerindeki özelliklerin beklenen dağılımını öğrenir. Eğitildikten sonra, dağılımsal farkları tespit etmek için sabit referanslar olarak hizmet vermeleri amacıyla dondurulur. Çekirdek varsayım, her yeniden inşâ ağı tarafından çıkarım sırasında ölçülen yeniden inşâ hatasının alan kayması için bir vekil olduğunu, çıkarım sırasında gözlemlenen özelliklerle eğitim sırasında gözlemlenenler arasındaki sapmaları belirlediğidir. En yüksek çözünürlük düzeyinde, uyumlanmış giriş xa‘nin ve görev modeli çıktısının ya‘nin yeniden inşâlarını üretmek için g̃3 ve g̃4 kullanılır; bunlar sırasıyla xa ve ya‘nin yeniden inşâlarıdır. İlgili yeniden inşâ hataları şöyle tanımlanır:
Denklemler 4 ve 5’te , ve sırasıyla , ve tarafından üretilen yeniden yapılandırmalardır ve ||·|| L1 uzaklığını ifade eder. Ara özellik seviyelerinde, n‘nin , içindeki toplam katman sayısını belirttiği yeniden yapılandırma modelleri kümesini kullanırız. Her i seviyesinde, , ‘nin simetrik yapısından yararlanarak kodlayıcı ve kod çözücü özelliklerini birleştiririz:
Denklemler 6’da ⊕ kanal bazlı birleştirmeyi ifade eder.
Ardından , karşılık gelen , üzerinden geçirilerek , elde edilir ve buna karşılık gelen yeniden yapılandırma hatası şöyle tanımlanır
Denklem 7’deki yeniden yapılandırma hatası, birleştirilmiş kodlayıcı ve kod çözücü özelliklerden hesaplanır. Bu birleştirme, her , ‘ye i seviyesinde özellik alanının daha kapsamlı bir temsilini sağlayarak, alan kaymasını işaret eden sapmaları tespit etme yeteneğini artırır.
3.2 Dağılım kayması için bir vekil olarak yeniden yapılandırma hatası
Yeniden yapılandırma hatası, kaynak alan eğitimi sırasında gözlemlenen temsillerle uyumun örnek düzeyinde bir ölçüsünü sağlar. Kaynak dağılımına uyarlanmış modeller tarafından kötü şekilde yeniden yapılandırılan örnekleri belirlemek için anormallık ve OOD (kaynak dışı) tespiti alanında kullanılmıştır (Gong ve ark., 2019; Zhou, 2022).
Her yeniden yapılandırma ağı, görev modelinin belirli bir seviyesindeki kaynak alan temsilileri üzerinde eğitilir. Eğitim sırasında gözlemlenenlere benzer temsililerin daha düşük yeniden yapılandırma hataları vermesi beklenirken, kaymış temsililerin daha büyük hatalar verebilir.
ℓ temsil seviyesiyle ilişkili yeniden yapılandırma ağını , karşılık gelen kaynak alan temsil dağılımını , göstermek üzere. Yeniden yapılandırıcı şöyle eğitilir
Denklem 8’de, zℓ, kaynak alan eğitim verisinden çıkarılan bir girdi, ara veya çıktı temsilini ifade eder.
Sınav anında, , karşılık gelen kaynak eğitmeli yeniden yapılandırıcı tarafından değerlendirilen temsil olsun. Yeniden yapılandırma hatası şöyle tanımlanır
Temsil seviyesine bağlı olarak, Denklem 9’daki , uyarlanmış girdi xa, bir ara temsil , veya uyarlanmış çıktı , karşılık gelir.
Elde edilen ϵx, ϵi ve ϵy hataları, sırasıyla giriş, ara ve çıkış seviyelerinde örnek bazlı uyumluluk puanları olarak değerlendirilir. Daha büyük değerler, ilgili yeniden inşa edicinin öğrendiği kaynak-alan temsilleriyle daha düşük uyumlu olduğunu gösterir. Önerilen çerçevede, adaptasyon öncesinde hesaplanan çıkış yeniden inşa hatası, TTA’nın aktive edilip edilmeyeceğini belirler. Adaptasyon tetiklendiğinde, her bir ω aday konfigürasyonu için adaptörler, giriş, seçilen ara ve çıkış seviyelerindeki yeniden inşa hatalarını minimize ederek birlikte optimize edilir:
Burada ω, aday konfigürasyonda aktive edilen ara adaptasyon seviyelerinin kümesini, θω seçilen adaptör modüllerinin parametrelerini ve adaptör ağırlıklarına uygulanan L2 parametre düzenlemesi teriminin katsayısını gösterir. Çıkış yeniden inşa hatası ϵy ardından aday konfigürasyonları karşılaştırmak ve özellik seviyesi adaptörlerinin en iyi alt kümesini seçmek için kullanılır.
3.3 Dinamik adaptasyon bloğu (DAB)
Şekil 1c’de gösterilen bu blok, giriş görüntüsünü x ve h1, h2, …, hn özelliklerini, RM’nin sağladığı bilgilerle alan kaymasına karşı dayanıklılığı iyileştirecek şekilde dönüştürür. i. seviyesinde özellik bazlı dönüşümler gerçekleştiren, eğitim edilebilir bileşenler olan adaptörlerden ve belirli bir özellik haritasının adaptasyon gerektirirek gerektirip gerektirmediğini belirleyen dinamik seçiciden oluşur. Adaptörler TTA sırasında eğitim edilebilecek tek bileşenlerdir ve RM’den gelen geri bildirimlere göre güncellenir; her bir yeniden inşa modülü i. DAB’deki karşılık gelen Ai adaptörüne eşlenir. En etkili adaptör alt kümesini belirlemek için, aday yeniden inşa modeli kombinasyonlarını RM içinde değerlendirerek adaptasyon sürecini yönlendiren ve alan kaymasını tahmin eden geri bildirimler kullanan yapılandırılmış bir arama çerçevesi öneririz.
Orta seviye yeniden yapılandırma modellerinin kümesi olsun. Buradan, arama sürecinde açıkça ve modellerinin çıkarıldığı belirtilmelidir: bir yandan, sabittir çünkü uyarlanmış giriş görüntüsü üzerinde doğrudan işlem yapar ve bu görüntü her zaman uyarlamaya tabi olur; diğer yandan, sürekli olarak uyarlanmış çıktı üzerindeki yeniden yapılandırma hatasını izlemek için kullanılır. Arama uzayı şu şekilde tanımlanır:
Eşitlik 11’de, her ω, TTA sırasında alan kaymasını tahmin etmek için aday bir yapılandırma olarak değerlendirilen, geçerli ve boş olmayan bir yeniden yapılandırma modeli alt kümesini temsil eder. Uzay Ω üzerinde bir arama stratejisi verilmiş olarak, her aday yapılandırma ω, sınırlı sayıda uyarlama adımı (M) üzerinde yeniden yapılandırma hatasını ölçmek için 5 ile değerlendirilir. Her adımda, uyarlanmış çıktı üretmek için TTA gerçekleştirilir; burada görev modeli, alan kaymasını tahmin etmek için ω içindeki yeniden yapılandırma modellerini kullanırken çıkarım yapar ve buna karşılık gelen uyarlayıcıları uygular. Ardından, yeniden yapılandırma hatasını hesaplarız; burada () uyarlanmış çıktıyı ve ise yeniden yapılandırma modeli tarafından üretilen karşılık gelen yeniden yapılandırmayı gösterir. En iyi yapılandırma ω, M adım boyunca en düşük yeniden yapılandırma hatasına ulaşan aday olarak seçilir.
Detaylı biçimde, giriş düzeyinde bir dönüştürücü Ax ve bir dize ara dönüştürücü bulunur; ara dönüştürücülerin sayısı mimarinin ilk yarısına karşılık gelir, çünkü her Ai, i derinliğindeki kodlayıcı ve n−i derinliğindeki kodçözücü katmanlarına simetrik olarak uygulanır. Ax, giriş görüntüsünün boyutunu koruyan bir dize evrişsel katman uygular. Ai, özellik haritalarını uzaysal çözünürlüğü değiştirmeden dönüştüren 1 × 1 boyutunda bir evrişsel katman olarak uygulanır. Dinamik bir seçici, verilen özellik haritasının dönüştürülüp dönüştürülmeyeceğine karar verir. Bu duruma göre ara özellik hi ya dönüştürücü ile Ai(·) dönüştürülür ya da I(·)’nin kimlik operatörü olduğu şekilde hi olduğu gibi bırakılır. TTA sırasında her dönüştürücü bağımsız olarak güncellenir ve böylece her test örneğinin yerel özelliklerine dayanarak özellik düzeyinde dönüştürme öğrenir. Her ara dönüştürücü Ai, hem kendisine karşılık gelen hi özellik hem de kodlayıcı ve kodçözücü kolları üzerinde bulunan simetrik eşi hn−i üzerinde uygulanır. Bu tasarım, simetrik katmanlar boyunca tutarlı bir dönüştürme sağlarken toplam parametre yükünü en aza indirir.
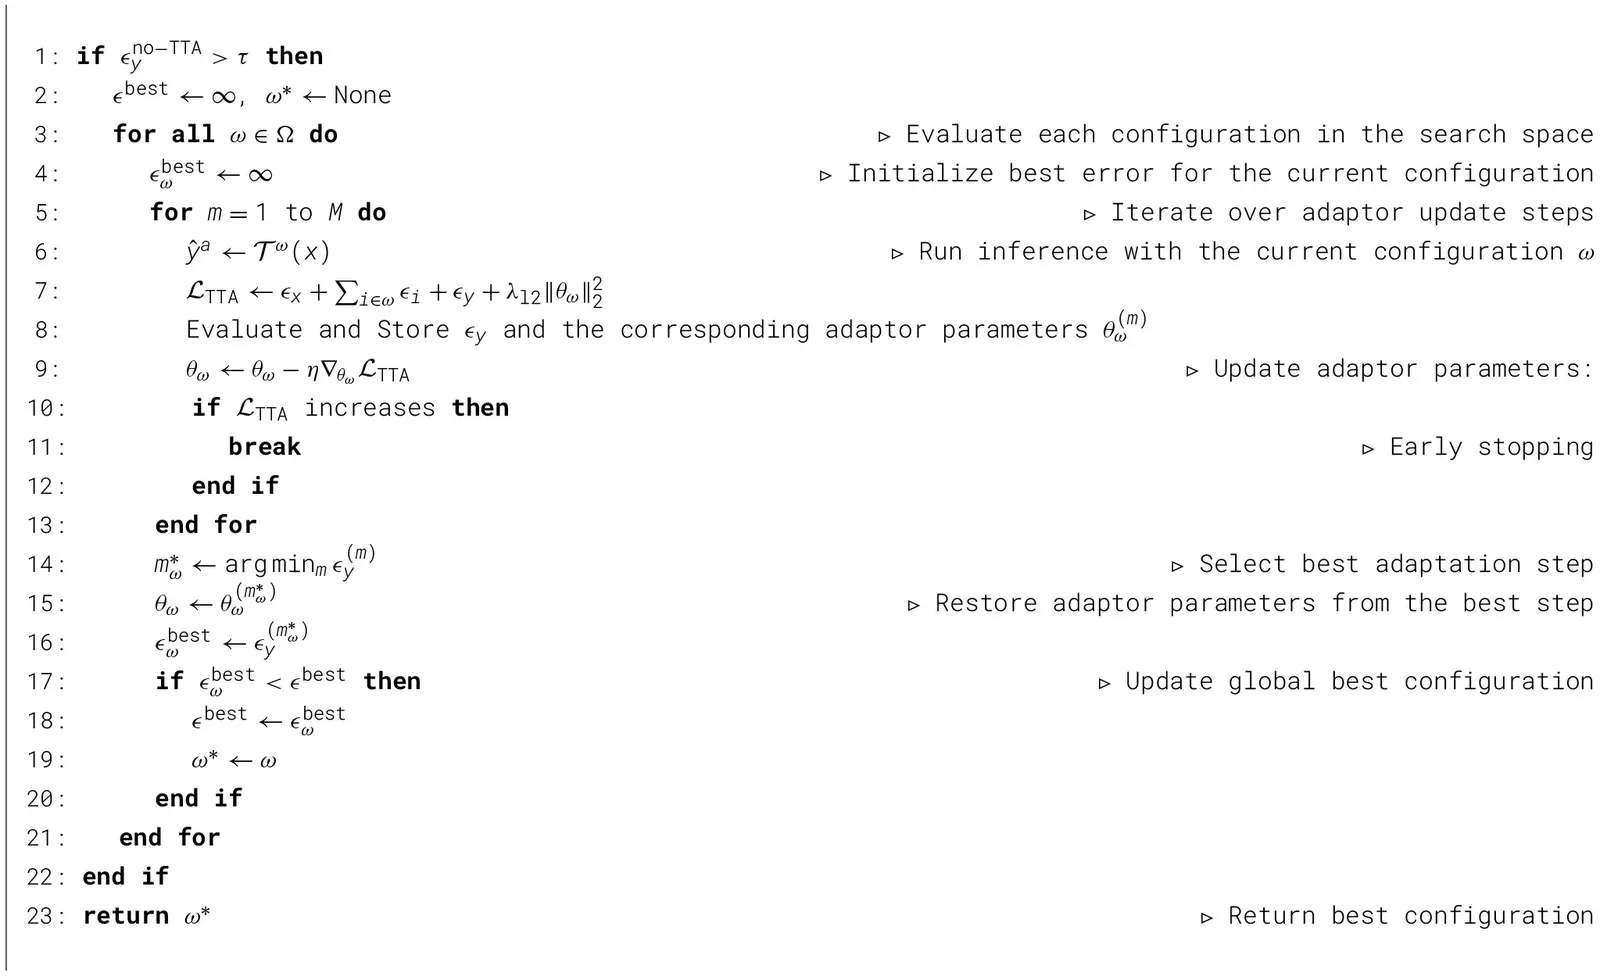
Örnek bilinçli TTA çerçevemizin temel uygulaması olarak kapsamlı bir ızgara araması stratejisi öneriyoruz. Algoritma 1’de ayrıntılı biçimde açıklandığı gibi, yöntem arama alanında Ω’daki tüm olası yeniden inşâ modeli yapılandırmalarını değerlendirerek her test örneği için en uygun özellik düzeyinde uyumlamayı belirler. Uyumlama yalnızca çıkış yeniden inşâ hatası ϵy sabit bir eşik τ değerini aştığında tetiklenir. Her bir aday yapılandırma ω ∈ Ω için ilgili dönüştürücü parametreleri aynı başlangıç durumuna sıfırlanır ve Denklem 10’daki TTA amacını minimize ederek en fazla M güncelleme adımıyla optimize edilir. TTA amacı önceki güncellemeye göre artarsa optimizasyon daha erken durabilir. Ardından çıkış yeniden inşâ hatası ϵy, aday yapılandırmaları karşılaştırmak ve en uygun ω yapılandırmayı seçmek için kullanılır.
4 Deneysel yapılandırma
Bu bölüm, TTA yaklaşımımızı değerlendirmek için kullanılan deneysel kurulumun bir özeti sağlar. 4.1, veri setlerini; temel özellikleri ve ön işleme adımlarıyla birlikte açıklar. 4.2, mimari seçimleri, eğitim yapılandırması, hiperparametre ayarları ve TTA protokolünü kapsayan uygulama ayrıntılarını aktarır. 4.3, çeviri kalitesini nicel olarak değerlendirmek için kullanılan metrikleri tanıtır. Son olarak 4.4, karşılaştırma için seçilen rakipleri açıklar.
4.1 Veri setleri
Yaklaşımımızı iki tıbbi görüntüden görüntüye çeviri görevinde değerlendiriyoruz: LDCT gürültü temizleme ve T1’den T2 MRI çevirisi. Tablo 3, veri setlerini, veri bölümlendirmelerini, görüntü boyutlarını ve çalışma kohortlarını özetler.
| Veri seti | Kaynak | Hedef | # Örnek | Eğitim seti | Test seti | Görüntü boyutu | Kohort |
|---|---|---|---|---|---|---|---|
| Mayo clinic (Moen ve ark., 2021) | LDCT | HDCT | 41 hastası, 11.069 dilim | 10 hastası, 5.936 dilim | 31 hastası, 5.133 dilim | 512 × 512 | Abdominal taramalar – karaciğer metastazları |
| Mayo clinic (Moen ve ark., 2021) | LDCT | HDCT | 19 hastası, 6.525 dilim | – | 19 hastası, 6.525 dilim | 512 × 512 | Göğüs taramaları – akciğer nodülleri |
| BraTS 2018 (Menze ve ark., 2014) | T1 MRI | T2 MRI | 34 hastası, 6.528 dilim | 34 hastası, 5.760 dilim | 4 hastası, 768 dilim | 240 × 240 | Beyin glioma hastaları |
| IXI (IXI Veri Seti, 2016) | T1 MRI | T2 MRI | 140 hastası, 2.800 dilim | – | 140 hastası, 2.800 dilim | 240 × 240 | Sağlıklı gönüllüler |
Örnek sayıları, eşleşmiş kaynak-hedef dilimlerini ifade eder. Veri seti adları kalın yazıyla vurgulanmıştır.
LDCT gürültü temizleme için, eşleştirilmiş yüksek dozlu BT (HDCT) taramaları ile çeyrek doz protokolü kullanılarak simüle edilmiş LDCT görüntülerini içeren Mayo Clinic LDCT ve Projeksiyon Verisi (Moen ve ark., 2021) kullanılmaktadır. Karın ve göğüs taramaları farklı anatomik alanlar olarak değerlendirilmektedir. Karın veri seti 41 hastadan oluşmakta ve buradan 11.069 eşleştirilmiş LDCT-HDCT dilimi çıkarılmaktadır. Hastaya dayalı bir ayrım yapılarak 10 hastalık (5.936 eşleştirilmiş dilim) eğitim, 31 hastalık (5.133 eşleştirilmiş dilim) ise kaynak-alan testinde kullanılmaktadır. Genelkleşmeyi anatomik dağılım kayması altında değerlendirmek için, görev modeli eğitimine dahil edilmemiş 19 göğüs hastasına karşılık gelen 6.525 eşleştirilmiş LDCT-HDCT diliminden oluşan ayrı bir set kullanılmaktadır. Her iki anatomik alan için ham DICOM görüntüleri Hounsfield Birimlerine (HU) dönüştürülmekte, −400 HU merkezli ve 1400 HU genişliğinde bir yoğunluk penceresi uygulanmakta ve ortaya çıkan değerler [−1, 1] aralığına ölçeklendirilmektedir.
T1’den T2 MRI çevirisinde, BraTS 2018 veri seti (Menze ve ark., 2014) kullanılmaktadır. Veri seti, birden fazla merkezde elde edilmiş ve veri seti yazarları tarafından ön işlenmiş ameliyat öncesi MRI taramalarını içermektedir. Veri seti 34 hastadan oluşmakta ve buradan 6.528 eşleştirilmiş MRI dilimi seçilmektedir; her bir dilim, uzaysal olarak karşılık gelen T1- ve T2-ağırlıklı görüntülerden oluşmaktadır. Hastaya dayalı bir ayrım yapılarak 30 hastalık (5.760 eşleştirilmiş dilim) eğitim, 4 hastalık (768 eşleştirilmiş dilim) ise kaynak-alan testinde kullanılmaktadır.
IXI veri kümesini (IXI Dataset, 2016), T1’den T2’ye çeviri için dış test kümesi olarak kullanıyoruz. IXI, Londra’daki iki klinik merkezde toplanan, sağlıklı katılımcılardan elde edilen eşleşmiş T1- ve T2- ağırlıklı beyin MRI hacmleri içerir: Hammersmith Hastanesi’nde Philips 3T tarayıcı ve Psikiyatri Enstitüsü’nde Philips 1.5T tarayıcı kullanılarak. BraTS’a göre IXI, hem edinimle ilgili hem de kohort düzeyinde kaymalar getirir; çünkü farklı tarayıcılar ve görüntüleme protokolleriyle toplanan sağlıklı katılımcıları içerirken, BraTS glioma hastalarını içerir. He ve ark. (2021)’nın izleyerek hacimleri MNI alanına kaydırıyor, görüntü yoğunluklarını beyaz madde tepe noktasını kullanarak normalize ediyor ve hacimleri yeniden boyutlandırıyoruz. Eşleşmiş üç boyutlu T1- ve T2- ağırlıklı hacme sahip 140 katılımcı seçiyoruz. Her katılımcıdan, 120 ile 180 indeksleri arasında 3 mm dilimler arası mesafe kullanarak 20 karşılıklı ekseral dilim çifti çıkarıyoruz. Bu işlem 2.800 eşleşmiş iki boyutlu örnek üretiyor.
Değerlendirme, iki dağılım kayması ayarını içerir. Akciğer BT’si, eğitim için kullanılan abdominal alandan anatomik bir kayma temsil eder. IXI, BraTS’a göre dış edinim ve kohort kaymalarını temsil eder. Her iki ayarda da yeniden inşa hatası eşiği yalnızca ilgili kaynak alandan tahmin edilir ve kaymış test verisine değişmeden uygulanır. Dolayısıyla eşik kalibrasyonu, kaymış test dağılımlarının istatistiklerini kullanmaz.
4.2 Uygulama ayrıntıları
Çerçeve üç bileşenden oluşur: bir görev modeli, bir dizi yeniden inşâ modeli ve bir dizi hafif uyarlayıcı. Görev modeli olarak CycleGAN (Zhu et al., 2017) uyguladık. Burada göz önüne alınan tüm veri setleri uzaysal olarak karşılık gelen kaynak-hedef çiftleri sunduğu için, üreticilere ek olarak özgün formülasyonun karşıtı, döngü tutarlılığı ve özdeşlik terimleriyle birlikte, eşleşmiş hedefe karşı bir ℓ1 yeniden inşâ kaybıyla gözetim uygulanır. Her yeniden inşâ ağı, girişe, arada bir özellik seviyesine ya da görev modelinin çıktısına eşlik eden bir evirimsel ağaçtır. Giriş uyarlayıcısı sığ bir evirimsel ağaç olarak, arada bulunan uyarlayıcılar ise 1 × 1 evirimsel ağaçlar olarak uygulanır.
Her çeviri görevi için ayrı bir görev modeli, başlangıç öğrenme hızı 2 × 10⁻⁴ ve parti boyutu 8 olan Adam optimize edicisiyle eğitilir. Öğrenme hızı ilk 50 dönem boyunca sabit kalır, ardından sonraki 50 dönemde sıfıra doğru doğrusal olarak azalır; toplamda 100 dönem. Bu strateji, karmaşık örüntüleri yakalamak için yeterli yinelemeye duyulan ihtiyacı karşılayırken aşırı öğrenmeyi de hafifletir. Öğrenme hızının azalması, eğitimin son aşamalarında yakınsamayı kararlılaştırır ve seçilen parti boyutu, bellek kısıtları ile eğitim kararlılığı arasında bir dengeyi yansıtır.
Her bir yeniden inşâ modeli, Adam optimizayonu ile bağımsız olarak eğitildi; başlangıç öğrenme hızı 1 × 10⁻³ ve parti boyutu 8 olarak ayarlandı. Eğitim süreci, sabir öğrenme hızıyla yürütülen 20 epoch ve ardından öğrenme hızının sıfıra doğru doğrusal olarak azaldığı 80 epoch olmak üzere toplamda 100 epochdan oluşuyor. Bu kurulum, tüm yeniden inşâ modelleri üzerinde eğitim dinamiklerinde tutarlılık sağlarken, her birinin görev modelinden çıkarılan farklı özelliklere odaklanarak özelleşmesine olanak tanıyor. TTA prosedürü için ayrı bir hiperparametre optimizasyonu gerçekleştirilmedi. Optimizayon ayarları, sabit uygulama tercihleri olarak ele alındı ve veri setleri ile deney ayarları boyunca değiştirilmeden korundu. TTA uygulanmadan önce, her bir örnek önce dondurulmuş görev modeli tarafından işlenir ve çıktı yeniden inşâ modeli üzerinden çıktı yeniden inşâ hatası ϵᵧ hesaplanır. TTA yalnızca ϵᵧ>τ olduğunda tetiklenir; burada τ, kaynak alanı eğitim verisi üzerinde hesaplanan yeniden inşâ hatası dağılımının 95. yüzdelik dilimi olarak belirlenir. Bu muhafazakâr eşik, kaynak alanı yeniden inşâ modeli tarafından zaten iyi temsil edilen örnekler üzerinde gereksiz uyumlamayı sınırlar ve uyumlamanın muhtemelen faydalı olmayacağı durumlarda önceden eğitilmiş görev modelini bozma riskini azaltır. IXI üzerinde dışsal OOD değerlendirmesi için τ, hedef-test istatistiklerinin sömürülmesinden kaçınmak ve önceden görülmemiş veri üzerinde dağıtımı simüle etmek amacıyla IXI test dağılımı üzerinde yeniden kalibre edilmez. Çerçevenin tetikleyici eşeğine duyarlılığını karakterize etmek için, tamamlayıcı malzeme—Ek A içinde ayrıca 85., 90. ve 98. yüzdelik dilimlerini kullanan sonuçlar da raporlanmaktadır.
TTA sırasında görev modeli ve tüm yeniden inşâ modelleri dondurulurken, yalnızca adaptörler optimize edilir. Yeniden inşâ hatası tetikleyicisiyle seçilen her örnek için, seçilen arama stratejisiyle tanımlanan aday adaptör yapılandırmaları değerlendirilir. Arama alanı yedi ara uyarlama seviyesinden oluşur ve giriş ile çıkış seviyeleri her zaman dahil olmak üzere 27−1 = 127 olası boş olmayan adaptör yapılandırması üretir. Her ω aday yapılandırması için, ilgili adaptörler optimizasyondan önce başlangıç ağırlıklarına sıfırlanır; böylece tüm yapılandırmalar aynı başlangıçtan değerlendirilir ve adaylar arasında bilgi sızıntısı önlenir. Adaptörler, 1 × 10⁻³ öğrenme hızına sahip Adam optimizayoruyla optimize edilir. Her aday yapılandırma, Denklem (10)’da tanımlanan TTA amacını minimize ederek en fazla M = 10 güncelleme adımında optimize edilir. Öğrenme hızı ve uyarlama adımlarının maksimum sayısı sırasıyla 1 × 10⁻³ ve M = 10 olarak sabitlenmiş ve alternatif değerler üzerinde sistematik bir arama yapılmadan tüm deneylerde kullanılmıştır. Toplam uyarlama kaybı önceki güncellemeye göre arttığında erken durdurma uygulanır. Uyarlama izinin ardından, optimizleme adımları sırasında gözlemlenen minimum çıkış seviyesi yeniden inşâ hatasına karşılık gelen adaptör parametreleri geri yüklenir ve aday yapılandırmanın nihai değerlendirmesinde kullanılır. Bu protokol, adaptör seçiminin her örnek için bağımsız olarak yapılmasını ve uyarlamanın yalnızca eklenen adaptör modüllerini etkileyerek önceden eğitilmiş görev modelinin değişmemesini sağlar. Tüm deneyler, bir NVIDIA A100 GPU ile donatılmış yüksek performanslı hesaplama kümesinde gerçekleştirilmiştir.
4.3 Değerlendirme metrikleri
Üretilen görüntülerin kalitesini nicelendirmek için üç yerleşik görüntü kalitesi değerlendirme metriği kullandık (Di Feola ve ark., 2023). Bunlar Mutlak Hata Ortalaması (MAE), Tepe Sinyal-Gürültü Oranı (PSNR) ve Yapısal Benzerlik İndeksi (SSIM)’dir.
MAE, oluşturulan ŷ görüntüsünün hedef görüntü y ile piksel değerleri arasındaki mutlak farkı ölçer:
Denklem 12’de m ve n görüntülerdeki sırasıyla satır ve sütun sayısını; yi, j ve ŷi, j ise y ve ŷ‘nin i-inci satır ve j-inci sütunundaki piksel elemanlarını gösterir. [0, +∞] aralığında değişir ve daha düşük MAE değeri, y ile ŷ arasında daha iyi uyum olduğunu belirtir. PSNR, normalize edilmiş görüntülerin sabit veri aralığı (MAXI) ile oluşturulan ŷ görüntüsü ile hedef y görüntüsü arasındaki hata arasındaki ilişkiyi, karelerin ortalaması (MSE) ile ölçülerek karşılaştırır:
Denklem 13’teki sabit yoğunluk aralığında, daha düşük MSE değeri daha yüksek PSNR ve dolayısıyla daha iyi görüntü kalitesi anlamına gelir.
SSIM (Wang ve ark., 2004), iki görüntü arasındaki benzerliği parlaklık, kontrast ve yapı fonksiyonu olarak hesaplar:
Denklem 14’te μŷ ve μy sırasıyla ŷ ve y‘nin ortalamaya dayalı piksel yoğunluklarını; σŷ ve σy varyansları, σŷy kovaryansı; c1 ve c2 ise sayısal kararsızlıkları önlemek için kullanılan sabit değerleri gösterir. SSIM [0, 1] aralığında değişir; değeri ne kadar yüksekse, iki görüntü arasındaki benzerlik o kadar fazladır. Uygulamamızda SSIM, normalize edilmiş gri tonlu görüntüler üzerinde 7 × 7 yerel pencere kullanılarak hesaplanır ve diğer parametreler scikit-image uygulamasındaki varsayılan değerlerine bırakılır.
4.4 Rakipler
Önerilen yöntemi, adaptasyon içermeyen görev modeli ve üç TTA rakibiyle karşılaştırıyoruz. İlk temel yaklaşım olarak adlandırılan No TTA, herhangi bir test-zamanı değişikliği uygulanmadan, önceden eğitilmiş görüntüden-görüntüye çevirme modelinin ŷ doğrudan çıkarım sırasında değerlendirilmesiyle karşılık gelir. Bu yapılandırma, TTA’nın sağladığı faydanın nicelendirilmesi için referans noktası olarak hizmet verir.
İlk TTA rakibi olarak Karani ve ark. (2021)’yı değerlendiriyoruz; bu yöntem, sağlam tıbbi görüntü segmentasyonu için önerilen bir TTA metodudur. Orijinal formülasyon, kaynak-alan çıktılarında eğitilen bir otomatik kodlayıcı öncelliğiyle yönlendirilen, çıkarım sırasında ince bir normalizasyon ağını optimize ederek giriş düzeyinde uyarlamayı gerçekleştirir. Yöntem segmentasyon için tasarlandığından, temel prensibi görüntüden-görüntüye çeviri ortamımıza uyarlayarak, önceden eğitilmiş görev modelinin donuk (değiştirilmez) kalması koşuluyla giriş düzeyinde çıkarım zamanı optimizasyonu uyguluyoruz. Bu karşılaştırma, yalnızca giriş düzeyinde uyarlamanın jeneratif tıbbi görüntü çevirisinde alan kaymasını telafi etmek için yeterli olup olmadığını değerlendirmemizi sağlar.
İkinci TTA rakibi olarak ise SPA (Niu ve ark., 2025)’yı değerlendiriyoruz; bu, regresyon ve sınıflandırma görevleri için tasarlanmış kendiliğinden kendini iyileştiren bir TTA metodudur. SPA (Niu ve ark., 2025), orijinal test görüntüsünden elde edilen tahminle, aynı görüntünün bozulmuş bir görünümünden elde edilen tahmin arasında tutarlılığı zorlayarak uyarlanır. Bu prensibi görüntüden-görüntüye çeviriye şu şekilde uyarlıyoruz: bozulmuş görünümü Gauss gürültüsü enjeksiyonuyla üretiyor ve karşılık gelen çevrilmiş görüntüler arasında bir ℓ1 tutarlılık kaybını minimize ediyoruz. Orijinal görüntüden üretilen tahmin, duraklatma-gradyan (stop-gradient) işlemiyle sabit bir sahte hedef olarak ele alınıyor. Önceden eğitilmiş CycleGAN, eğitilebilir normalizasyon parametrelerini ortaya çıkarmayan non-affine Örnek Normalizasyonu (Instance Normalization) kullandığından, uyarlama jeneratörün konvolüsyonel parametrelerinin güncellenmesiyle gerçekleştiriliyor. Çıkış yeniden inşalama modeli, yalnızca SPA’ın aktivasyonunun belirlenmesi için, önerilen çerçeveyle aynı yeniden inşalama hatası tetikleyicisini kullanarak kullanılıyor ve SPA optimizasyon hedefine katkıda bulunmuyor. Bu yapılandırma, SPA ile önerilen yöntemin aynı örnek seçimi mekanizmasını paylaştığı ancak seçilen örneklerin nasıl uyarlandığı方面 farklılaştığı bir karşılaştırma olanakını sağlıyor.
Üçüncü rakip olarak He ve ark. (2021) incelenmiştir. Bilgimiz dahilinde, TTA için tıbbi görüntüden görüntüye çeviride açıkça bu sorunu ele alan tek önceki çalışma bu olup, yöntem otomatik bir kodlayıcı tabanlı yeniden yapılandırma kaybıyla yönlendirilen ince adaptör ağları aracılığıyla özellik düzeyinde adaptasyon gerçekleştirir. Ancak adaptasyon tüm örnek test örneklerine aynı şekilde uygulanmakta ve sabit bir adaptör yapılandırmasına dayanmakta; ID ve OOD girdileri arasında ayrım yapılmamakta ve uyarlanmış özellik seviyeleri örnek bazında seçilmemektedir.
Tüm yöntemler aynı test örnekleri üzerinde aynı görüntü kalitesi ölçümleriyle değerlendirilmektedir. Yeniden yapılandırma hatası tabanlı bir adaptasyon tetikleyicisi içermeyen rakipler için performansları, önerilen yöntemin yeniden yapılandırma hatası tetikleyicisiyle belirlediği B⊂A alt kümesi üzerinde raporlanmaktadır. Bu, hem tam test kümesi hem de adaptasyon gerektirdiği tespit edilen örnekler üzerinde kontrollü bir karşılaştırma olanakı sağlar.
5. Sonuçlar ve tartışma
Bu bölüm, önerilen örnek bilinirliğe sahip TTA çerçevesinin iki tıbbi görüntüden görüntüye çeviri görevi olan LDCT gürültüden arındırma ve T1’den T2’ye MRI çevirisi üzerinde kapsamlı bir değerlendirmesini sunar. Öncelikle, 5.1 ve 5.2, önerilen yaklaşımın temel görev modeli ve mevcut TTA yöntemlerine karşı etkinliğini nicel ölçütler ve görsel karşılaştırmalar aracılığıyla değerlendirir. 5.3, bu analizi temel-model tabanlı algısal bir değerlendirmekle tamamlar; bu değerlendirme, geleneksel piksel düzeyindeki ölçütlerin ötesinde yüksek düzeyli görüntü temsillerinin korunumunu inceler. Ardından, 5.4, çerçevenin ana bileşenlerinin katkısını; adaptor yerleştirmesi, seçici aktivasyon, örneğe özgü yapılandırma seçimi ve adaptor konvolüsyon tasarımı dahil olmak üzere değerlendirir. 5.5 ve 5.6, çerçevenin örnek düzeyindeki davranışını daha da inceler; seçici uyarlamanın sağladığı faydayı ve yeniden inşâ hatası, çeviri bozulması ile uyarlama kazançları arasındaki ilişkiyi analiz eder. 5.7, adaptor yapılandırma alanını keşfetmek için alternatif stratejileri değerlendirirken, 5.8 bunların uyarlama kalitesi ve hesaplama maliyeti açısından getiri-performans dengelemesini inceler.
5.1 Örken bilinirliğe sahip TTA’nın nicel değerlendirmesi
Tablo 4, karın ve göğüs LDCT gürültüden arındırma, BraTS 2018 üzerinde T1’den T2’ye MRI çevirisi ve IXI üzerinde dış değerlendirmeye ilişkin nicel sonuçları bildirir. Performans, tam test kümesi A üzerinde ve önerilen yeniden inşâ hatası tetikleyicisiyle belirlenen B⊂A alt kümesi üzerinde ölçülür. Eşik değeri τ, eğitim kümesi üzerinde hesaplanan yeniden inşâ hatası dağılımının 95. yüzdelik dilimi olarak ayarlanır ve BraTS’den IXI’ye değiştirilmeden aktarılır. No TTA, Karani ve ark. (2021) ve He ve ark. (2021) önerilen yeniden inşâ hatası tabanlı tetikleyiciyi içermez; B üzerindeki sonuçları, tetikleyicimizle seçilen örnekler üzerinde geriye dönük olarak hesaplanır. Buna karşılık, SPA (Niu ve ark., 2025) ve TTAGrid aynı tetikleyiciyi kullanır; bu da uyarlama mekanizmalarının aynı örnek seçimi altında kontrollü bir şekilde karşılaştırılmasını sağlar.
| Görev | Denej | SSIM ↑ | MAE ↓ | PSNR ↑ | ||||
|---|---|---|---|---|---|---|---|---|
| A | B⊂A | A | B⊂A | A | B⊂A |
| LDCT Gürültü Temizleme (karın taramaları) | Temel | TTA Yok | 0.887 ± 0.097 | 0.775 ± 0.054† | 0.038 ± 0.054 | 0.083 ± 0.021† | 31.175 ± 7.027 | 18.831 ± 1.655† |
| Rakipler | Karani et al. (2021) | 0.906 ± 0.079† | 0.801 ± 0.047† | 0.048 ± 0.036† | 0.042 ± 0.017† | 30.372 ± 5.299† | 30.486 ± 7.172† |
| SPA (Niu et al., 2025) | 0.889 ± 0.096 | 0.793 ± 0.061 | 0.038 ± 0.054 | 0.082 ± 0.026 | 31.236 ± 6.973 | 19.571 ± 3.406 |
| He et al. (2021) | 0.530 ± 0.100† | 0.546 ± 0.075† | 0.344 ± 0.102† | 0.334 ± 0.065† | 16.601 ± 1.615† | 16.456 ± 1.311† |
| Bizim yaklaşımımız | TTAGrid | 0.926 ± 0.034 | 0.900 ± 0.090 | 0.037 ± 0.020 | 0.034 ± 0.052 | 32.043 ± 3.657 | 32.302 ± 6.006 |
| LDCT Gürültü Temizleme (göğüs taramaları) | Temel | TTA Yok | 0.540 ± 0.103 | 0.244 ± 0.149 | 0.083 ± 0.030 | 0.230 ± 0.057 | 25.347 ± 2.484 | 15.598 ± 1.667 |
| Rakipler | Karani et al. (2021) | 0.515 ± 0.092† | 0.407 ± 0.206† | 0.093 ± 0.014† | 0.197 ± 0.046† | 22.446 ± 2.129† | 18.566 ± 4.900† |
| SPA (Niu et al., 2025) | 0.540 ± 0.103 | 0.245 ± 0.147 | 0.083 ± 0.030 | 0.228 ± 0.054 | 25.348 ± 2.478 | 15.637 ± 1.512 |
| He ve ark. (2021) | 0.269 ± 0.108† | 0.263 ± 0.126† | 0.423 ± 0.095† | 0.324 ± 0.017† | 15.031 ± 1.009† | 16.174 ± 0.582† |
| Bizim yaklaşımımız | TTAGrid | 0.661 ± 0.101 | 0.571 ± 0.137 | 0.081 ± 0.022 | 0.146 ± 0.033 | 25.444 ± 2.194 | 20.192 ± 2.775 |
| MRI T1-T2 (BraTS 2018) | Temel | TTA yok | 0.858 ± 0.040 | 0.866 ± 0.012† | 0.037 ± 0.010 | 0.039 ± 0.005† | 26.459 ± 1.864 | 25.241 ± 0.681† |
| Rakipler | Karani ve ark. (2021) | 0.820 ± 0.037† | 0.759 ± 0.015† | 0.050 ± 0.004† | 0.072 ± 0.002† | 25.443 ± 1.905† | 18.415 ± 0.703† |
| SPA (Niu ve ark., 2025) | 0.848 ± 0.040 | 0.764 ± 0.011 | 0.037 ± 0.010 | 0.039 ± 0.004 | 26.451 ± 1.862 | 24.290 ± 0.649 |
| He ve ark. (2021) | 0.330 ± 0.519 | 0.279 ± 0.031† | 0.571 ± 0.060 | 0.591 ± 0.059† | 7.23 ± 0.899 | 7.701 ± 0.844† |
| Bizim yaklaşımımız | TTAGrid | 0.858 ± 0.040 | 0.861 ± 0.020 | 0.037 ± 0.011 | 0.043 ± 0.010 | 26.445 ± 1.890 | 24.951 ± 1.327 |
| MRI T1-T2 (IXI) | Temel | TTA yok | 0.692 ± 0.046 | 0.700 ± 0.048† | 0.115 ± 0.022 | 0.126 ± 0.018† | 18.622 ± 1.347 | 17.953 ± 1.044† |
| Rakipler | Karani ve ark. (2021) | 0.725 ± 0.035† | 0.727 ± 0.034† | 0.099 ± 0.022† | 0.092 ± 0.021† | 18.696 ± 1.655† | 17.724 ± 1.303† |
| SPA (Niu ve ark., 2025) | 0.687 ± 0.045 | 0.692 ± 0.048 | 0.119 ± 0.024 | 0.132 ± 0.020 | 18.405 ± 1.483 | 17.597 ± 1.094 |
| He ve ark. (2021) | 0.289 ± 0.115 | 0.271 ± 0.114† | 0.481 ± 0.123 | 0.504 ± 0.115† | 9.851 ± 2.018 | 9.470 ± 1.536† |
| Bizim yaklaşımımız | TTAGrid | 0.739 ± 0.068 | 0.771 ± 0.060 | 0.093 ± 0.022 | 0.088 ± 0.024 | 20.042 ± 1.968 | 20.317 ± 2.275 |
Ölçümler tüm test kümesi A ve B⊂A alt kümesi için raporlanmaktadır. Her görev için en iyi sonuçlar yeşille vurgulanmaktadır. Hanje simgesi (†), örnek seçimi mekanizması içermeyen ancak doğrudan karşılaştırma yapılabilmesi için yaklaşımımızın örneklemeyi uyarladığı yeniden yapılandırma hatası tetikleyicisi tarafından belirlenen B⊂A alt kümesi üzerinde değerlendirilen rakipleri göstermektedir.
Abdominal LDCT gürültü gidermede TTAGrid, hem AB üzerinde en iyi SSIM, MAE ve PSNR değerlerine ulaşmaktadır. Tam test kümesinde No TTA’ya kıyasla SSIM’i 0.887’den 0.926’ya ve PSNR’i 31.175’ten 32.043 dB’ye yükseltirken, MAE’yi 0.038’den 0.037’ye düşürmektedir. Avantaj, tetikleyici tarafından seçilen alt kümede daha büyüktür: No TTA’ya kıyasla SSIM 0.125 artmakta, MAE 0.049 azalmakta ve PSNR 13.471 dB artmaktadır. Rakipler arasında Karani ve ark. (2021), B üzerinde en güçlü performansı sunmakla birlikte, üç ölçümün tümünde TTAGrid’in altında kalmaktadır. SPA (Niu ve ark., 2025) uyarlansız görev modeliye yakın kalmakta, He ve ark. (2021)’nın sabit özellik düzeyinde uyarlama ise belirgin bir bozulmaya yol açmaktadır.
Göğüs LDCT sonuçları, görev modeli eğitimi sırasında gözlemlenmeyen bir anatomik alana genelleşmeyi değerlendirir. Aynı ayarında TTAGrid, her iki değerlendirme alt kümesinde de tüm ölçütlerde birinci sırayı alır. B üzerinde No TTA’ya göre iyileşme özellikle belirgindir: SSIM 0.244’ten 0.571’e, MAE 0.230’dan 0.146’ya düşer ve PSNR 15.598’den 20.192 dB’e yükselir. Karani ve ark. (2021), tetikleyici tarafından seçilen örneklerdeki bozulmayı kısmen azaltır, ancak önerilen yöntemden tutarlı şekilde aşağıda kalır. SPA (Niu ve ark., 2025) No TTA’dan neredeyse değişmeyen sonuçlar üretirken, He ve ark. (2021) tarafından elde edilen sonuçlar, heterojen test girdileri üzerinde sabit özellik-seviyesi yapılandırmasının uygulanmasının sınırlamalarını daha da ortaya koyar.
BraTS 2018 üzerinde farklı bir davranış gözlemlenir. No TTA, en iyi performansı gösteren yapılandırma olmaya devam eder. A üzerinde TTAGrid, SSIM ve MAE için bildirilen hassasiyette No TTA ile eşleşirken, 26.459 dB ile karşılaştırıldığında neredeyse aynı olan 26.445 dB PSNR üretir. Sadece B üzerinde sınırlı bir bozulma gözlemlenir: SSIM 0.866’dan 0.861’e, MAE 0.039’dan 0.043’e ve PSNR 25.241’den 24.951 dB’e düşer. SPA (Niu ve ark., 2025), her iki alt kümede de MAE’de No TTA ile eşleşmekle birlikte, özellikle B üzerinde SSIM ve PSNR’da daha büyük azalmalar üretir. BraTS sonuçları, TTA’nın çoğunlukla ID (kaynak içi) bir ayarda ölçülebilir bir fayda sağlamadığını ve zaten kaynak dağılımı için optimize edilmiş temsil bozulmalarını uyartarak performansı düşürebileceğini doğrular.
Dış IXI değerlendirmesi ise BraTS’a kıyasla edinimle ilgili ve kohort düzeyinde kaymalar getiriyor. Bu ayar altında TTAGrid, hem A hem de B’de bildirilen tüm metriklerde en iyi performansı sağlıyor. No TTA’ya göre A’da SSIM’i 0.047 artırıyor, MAE’yi 0.022 azaltıyor ve PSNR’i 1.420 dB artırıyor. Kazançlar B’de daha büyük hale geliyor; burada SSIM 0.700’den 0.771’e, MAE 0.126’dan 0.088’e ve PSNR 17.953’ten 20.317 dB’e yükseliyor. Karani ve ark. (2021) de SSIM ve MAE’yi iyileştirerek giriş düzeyinde uyarlamanın bu kaymayı kısmen telafi edebileceğini gösteriyor; ancak tetikleyiciyle seçilen alt kümede PSNR’i iyileştirmiyor ve TTAGrid’in altında kalıyor. SPA (Niu ve ark., 2025), önerilen yöntemle aynı tetikleyiciyi kullanmasına rağmen No TTA’ya göre hafifçe daha düşük performans gösterirken, He ve ark. (2021) tutarlı şekilde en düşük çeviri kalitesini üretiyor.
Sonuçlar, seçici aktivasyon ve örneğe özgü uyarlamanın katkılarını ayırıyor. Aynı yeniden inşâ hatası tetikleyicisini paylaşan SPA (Niu ve ark., 2025) ile TTAGrid arasındaki karşılaştırma, uyarlanacak örneklerin seçilmesinin yeterli olmadığını gösteriyor; uyarlama mekanizmasının aynı zamanda her giriş için uygun özellik seviyeleri ve dönüşümleri de belirlemesi gerekiyor. Önerilen yöntem anatomik, edinimle ilgili veya kohort düzeyinde kaymalar altında en etkili şekilde çalışıyor.
5.2 Nicel olmayan analiz
Şekiller 2–5, LDCT gürültü azaltma ve T1’den T2 MRI çevirisi için temsilî görsel karşılaştırmaları sunuyor. Her şekil kaynak görüntüyü, hedef referansı, uyarlama olmadan elde edilen tahmini ve değerlendirilen TTA yöntemleri tarafından üretilen çıktıları bildiriyor. Yakınlaştırılmış bölgeler, tam görüntü ölçeğinde daha az belirgin olabilen gürültü azaltma, yoğunluk koruma ve anatomik yapıdaki yerel farkları öne çıkarıyor.
Şekil 2’de gösterilen abdominal BT örneğinde, No TTA ve SPA (Niu et al., 2025) seçili bölgede belirgin yerel yoğunluk sanallarını ortaya koyarken, Karani et al. (2021) yapılı gürültüyü korur, He et al. (2021) ise vurgulanan anatomik yapının ötesine uzanan düzensiz yoğunluk dağılımı üretir. Buna karşılık TTAGrid, daha homojen bir yeniden yapılandırma sağlar, yüksek doz referansına daha yakın zayıflama örüntüleri ve komşu yumuşak doku yapıları arasındaki sınırların daha net korunumu sunar.
Şekil 3’deki BT örneği benzer bir örüntü gösterir. No TTA ve SPA (Niu et al., 2025) arka torasik yapıların etrafında belirgin düşük yoğunluklu sanalları ortaya koyarken, Karani et al. (2021) ve He et al. (2021) görünür gürültü ve yerel doku tutarsızlıklarını korur. TTAGrid bu sanalları daha iyi baskılarken omur cisminin ve çevreleyen akciğer dokusunun morfolojisini korur. Bu örnekler, LDCT üzerindeki nicel sonuçları destekler; örnek bazında giriş ve özellik düzeyinde adaptasyon, sabit ya da yalnızca girişe dayalı adaptasyon stratejilerinde gözlemlenen bozulmaları ortaya çıkarmadan gürültü temizlemeyi iyileştirir.
MR görüntülemesi için farklı bir davranış gözlemlenir. Şekil 4’deki BraTS örneğinde, No TTA tahmini zaten T2 referansının başlıca anatomik yapılarını ve yerel kontrastını yeniden üretir. SPA (Niu et al., 2025) ve TTAGrid’in çıktıları No TTA’ya yakın kalmakta ve belirgin niteliksel bir iyileşme sağlamamaktadır. Buna karşılık Karani et al. (2021) düzeltme ve anatomik detay kaybı ortaya çıkarırken, He et al. (2021) belirgin yoğunluk ve doku bozulmalarını üretir. Bu örnek, BraTS üzerindeki nicel sonuçlarla uyumludur; TTA’nın ID örnekleri için sınırlı ya da hiç yararlanma sağladığını ve gereksiz adaptasyonun zaten uygun bir tahmini bozabileceğini göstermektedir.
Şekil 5’teki IXI örneği, yöntemlerin dış alan kayması altındaki davranışını göstermektedir. Yalnızca TTA, T2 referansının kontrast ve doku görünümünü kısmen yeniden üretir. He ve ark. (2021) belirgin bir yoğunluk kayması ortaya koyarken, Karani ve ark. (2021) azaltılmış doku ayrımıyla aşırı pürüzsüz bir çıktı üretir. SPA (Niu ve ark., 2025) tarafından üretilen tahmin temel anatomik yapıları korur ancak değişmiş yerel kontrast ve sınır artefaktları sergiler. Uyarlanmış çıktılar arasında TTAGrid, seçilen bölgede referansla en yakın uyumu sağlar, dokuların uzamsal düzenini korurken rekabet eden yöntemlerde gözlemlenen ciddi yoğunluk bozulmalarından kaçınır. İnce anatomik detaylarda bir miktar azalma kalmaya devam eder; bu da uyarlamanın tahmini iyileştirdiğini ancak alan kaymasını tamamen telafi etmediğini gösterir.
Kalitatif sonuçlar, TTA’yı sınırlayan iki ayrı koşulu ortaya koyar. İlki, donuk görev modelinin zaten doğru bir tahmin sunduğu durumda uyarlamanın gereksiz olabileceğidir; bu BraTS örneğinde görüldüğü gibidir. İkincisi, alan kayması olsa bile, kendinden gözetimli uyarlama amacının her örnek için çeviri sadakatinden tamamen ayrı kalmayabileceğidir, bu da IXI üzerinde gösterilmektedir. Bu gözlemler hem seçici aktivasyonu hem de örneğe özgü adaptör seçimini teşvik ederken, yeniden inşa amaç uyumunu da kalan bir hata modu olarak işaretler.
5.3 Taban-model tabanlı algısal değerlendirme
MAE, PSNR ve SSIM gibi piksel düzeyindeki ölçütler yeniden inşa sadakatinin nicel ölçülerini sağlasa da, tıbbi görüntü sentezinde yüksek düzeyli anatomik yapıların korunması ve tutarlı semantik uyumunu tamamen yakalamayabilir. Bu nedenle, çevrilen görüntüleri ayrıca taban modellerden çıkarılan temsiller kullanarak değerlendiririz.
Üretilen görüntülerden çıkarılan gömme vektörleri ile karşılık gelen ground-truth görüntüler arasında kosinüs benzerliği hesaplarız. Yüksek benzerlik, sentezlenen ve referans görüntüler arasındaki daha yakın hizalamayı gösterir. Hem görüntü düzeyinde semantik bilgi sağlayan global gömme vektörlerini hem de yerelleştirilmiş temsil sağlayan yoğun gömme vektörlerini değerlendiririz.
Ebeveyn alanına özgü önceden eğitimin etkisini incelemek için birbirini tamamlayan iki temel model kullanırız. MedDINOv3 (Li ve ark., 2025), CT verileri üzerinde önceden eğitilmiş bir tıp temel modeli olup alanına özgü bir temsil sağlar; DINOv3 ise (Siméoni ve ark., 2025) hem CT hem de MRI verileri için alanından bağımsız bir referans sağlamak amacıyla genel amaçlı bir vizual temel model olarak kullanılır. Her test örneği için, TTAGrid uygulanmadan önce ve sonra üretilen çıktından gömme vektörleri çıkarılır ve bunlar karşılık gelen ground-truth hedef görüntüsünden çıkarılan vektörlerle karşılaştırılır.
Tablo 5’te bildirilen sonuçlar, geleneksel görüntü kalitesi metrikleriyle elde edilen bulguları desteklemektedir. Test dağılımının eğitim alanından farklı olduğu LDCT gürültü giderme ve harici IXI MRI veri kümesinde TTA, hem MedDINOv3 hem de DINOv3 temsillerinde üretilen ve ground-truth görüntüler arasındaki benzerliği artırır. Bu, uyarlanan çıktıların yalnızca piksel düzeyinde sadakat açısından değil, aynı zamanda referans görüntüleriyle uyumlu, daha tutarlı üst düzey temsiller de sağladığını gösterir.
| Görev | Özellik türü | MedDINOv3 | DINOv3 | ||
|---|---|---|---|---|---|
| TTA yok | TTAGrid | TTA yok | TTAGrid | ||
| LDCT gürültü temizleme (karın taramaları) | Global | 0.942 ± 0.023 | 0.981 ± 0.016 | 0.897 ± 0.036 | 0.963 ± 0.019 |
| Sık | 0.925 ± 0.027 | 0.976 ± 0.018 | 0.849 ± 0.039 | 0.936 ± 0.025 | |
| LDCT gürültü temizleme (göğüs taramaları) | Global | 0.906 ± 0.025 | 0.951 ± 0.017 | 0.796 ± 0.064 | 0.813 ± 0.068 |
| Sık | 0.834 ± 0.043 | 0.900 ± 0.032 | 0.752 ± 0.060 | 0.771 ± 0.066 | |
| MRI T1-T2 (BraTS 2018) | Global | 0.930 ± 0.008 | 0.927 ± 0.009 | 0.914 ± 0.012 | 0.863 ± 0.033 |
| Sık | 0.884 ± 0.010 | 0.870 ± 0.015 | 0.903 ± 0.013 | 0.840 ± 0.038 | |
| MRI T1-T2 (IXI) | Global | 0.813 ± 0.035 | 0.838 ± 0.038 | 0.751 ± 0.056 | 0.769 ± 0.059 |
| Sık | 0.724 ± 0.038 | 0.747 ± 0.041 | 0.707 ± 0.058 | 0.730 ± 0.062 |
Kosin benzerliliği, oluşturulan görüntülerden ve karşılık gelen gerçek etiket (ground-truth) görüntülerinden çıkarılan özellikler için hem global hem de sık özellikler hesaplanır. Her göreve ait en iyi sonuçlar yeşille vurgulanır.
BraTS 2018 veri setinde, eğitim dağılımıyla uyumlu bir değerlendirme senaryosunu temsil eden bu veri setinde TTAGrid ek bir fayda sağlamaz ve gömme benzerliliğini hafifçe azaltır. Bu gözlem, önceki nicel analizle tutarlıdır ve eğitim dağılımıyla zaten uyumlu örnekler üzerinde gereksiz uyarlamanın istenmeyen özellik dönüşümleri yaratabileceğini bir kez daha doğrular.
5.4 Önerilen çerçevenin ortadan kaldırma (ablation) çalışması
Önerilen çerçevenin bileşenlerinin katkısını analiz etmek için birbirini tamamlayan iki ayrıntılı çalışma gerçekleştiriyoruz. İlk olarak, adapteör yerleşiminin ve önerilen örnek bilinirliğinde uyarlama stratejisinin etkisini inceliyoruz. İkinci olarak, adapteör modülleri içinde kullanılan farklı evrişsel operatörlerin etkisini değerlendiriyoruz. Tüm deneyler, gözlemlenen eğilimlerin farklı çeviri senaryoları boyunca tutarlılığını değerlendirmek için değerlendirilen üç veri setinde yapılıyor.
5.4.1 Adapteör yerleşimi ve örnek bilinirliğinde uyarlama
Cesim 6, farklı adapteör bileşenlerinin katkısını ve örnek bazında uyarlamanın etkisini gösteren ayrıntılı çalışmayı raporluyor. İlk konfigürasyonlar yalnızca giriş temsilinin, yalnızca ara özellik temellerinin ya da her iki seviyenin birden uyarlamanın etkisini değerlendiriyor. Bu deneyler, farklı uyarlama seviyelerinin katkısı hakkında bilgi veriyor ve birden fazla adapteörün birleştirilmesinin etkisinin gözlenen veri setine ve uyarlama ayarına bağlı olduğunu gösteriyor.
| Görev | Ax | Ai | τ | N | SSIM↑ | MAE↓ | PSNR↑ |
|---|
| LDCT Gürültü Temizleme (abdominal taramalar) | ✓ | × | × | 5,133 | 0.893 ± 0.092 | 0.035 ± 0.052 | 32.050 ± 6.206 |
| × | ✓ | × | 5,133 | 0.891 ± 0.052 | 0.034 ± 0.058 | 32.036 ± 3.948 |
| ✓ | ✓ | × | 5,133 | 0.882 ± 0.043 | 0.039 ± 0.021 | 31.163 ± 4.085 |
| ✓ | × | ✓ | 438 | 0.860 ± 0.058 | 0.052 ± 0.026 | 25.432 ± 6.925 |
| × | ✓ | ✓ | 438 | 0.820 ± 0.027 | 0.037 ± 0.012 | 32.000 ± 4.197 |
| ✓ | ✓ | ✓ | 438 | 0.899 ± 0.024 | 0.037 ± 0.014 | 32.000 ± 5.262 |
| ✓ | ω | ✓ | 438 | 0.900 ± 0.090 | 0.034 ± 0.052 | 32.302 ± 6.006 |
| LDCT Gürültü Temizleme (akciğer taramaları) | ✓ | × | × | 6,525 | 0.538 ± 0.103 | 0.184 ± 0.029 | 19.318 ± 2.379 |
| × | ✓ | × | 6,525 | 0.519 ± 0.110 | 0.181 ± 0.023 | 19.107 ± 2.112 |
| ✓ | ✓ | × | 6,525 | 0.506 ± 0.110 | 0.187 ± 0.021 | 18.753 ± 2.002 |
| ✓ | × | ✓ | 138 | 0.249 ± 0.161 | 0.215 ± 0.064 | 16.900 ± 4.034 |
| × | ✓ | ✓ | 138 | 0.257 ± 0.159 | 0.162 ± 0.043 | 19.325 ± 3.689 |
| ✓ | ✓ | ✓ | 138 | 0.250 ± 0.156 | 0.149 ± 0.036 | 19.698 ± 3.272 |
| ✓ | ω | ✓ | 138 | 0.571 ± 0.137 | 0.146 ± 0.033 | 20.192 ± 2.775 |
| MRI T1-T2 (IXI) | ✓ | × | × | 2,800 | 0.690 ± 0.040 | 0.115 ± 0.035 | 18.600 ± 0.241 |
| × | ✓ | × | 2,800 | 0.690 ± 0.021 | 0.118 ± 0.044 | 18.500 ± 0.342 |
| ✓ | ✓ | × | 2,800 | 0.690 ± 0.022 | 0.118 ± 0.042 | 18.500 ± 0.540 |
| ✓ | × | ✓ | 1,829 | 0.700 ± 0.043 | 0.126 ± 0.036 | 17.700 ± 0.259 |
| × | ✓ | ✓ | 1,829 | 0.700 ± 0.020 | 0.126 ± 0.041 | 18.000 ± 0.342 |
| ✓ | ✓ | ✓ | 1,829 | 0.700 ± 0.022 | 0.126 ± 0.043 | 18.000 ± 0.567 |
| ✓ | ω | ✓ | 1,829 | 0.771 ± 0.060 | 0.088 ± 0.024 | 20.317 ± 2.275 |
N, bildirilen metriklerin hesaplandığı örnek sayısını gösterir. Ai için ✓, tüm ara dönüştürücülerin aktive edildiğini; ω ise TTAGrid tarafından seçilen örnek-özel alt kümei işaret eder. Her görev için en iyi sonuçlar yeşille vurgulanmıştır.
Ablasyon çalışmasının ikinci bölümü, önerilen yeniden yapılandırma hatası temelli tetikleyici ile ve olmadan aynı dönüştürücü yapılandırmaları değerlendirerek seçici uyarlanmanın rolünü inceler. Sonuçlar, örnek-özel stratejinin değerlendirilen veri setleri üzerinde rastgele uyarlanmaya kıyasla yeniden yapılandırma kalitesini iyileştirdiğini veya koruduğunu göstermektedir. Özellikle TTAGrid, değerlendirilen yapılandırmalar arasında en yüksek performansa ulaşarak, her test örneği için dönüştürücü yapılandırmasının bağımsız olarak seçilmesinin etkisini ortaya koymaktadır.
5.4.1.1 Dönüştürücü evrimleşmeli tasarım
Dönüştürücü modüllerinde kullanılan evrimleşmeli operatörün etkisini incelemek için üç alternatifi karşılaştırıyoruz: standart 1 × 1 evrimleşmeli, derinlemesine 3 × 3 evrimleşmeli ve derinlemesine-ayrılabilir 3 × 3 evrimleşmeli; sonuncu, derinlemesine uzaysal evrimleşmeyi takiben noktasal 1 × 1 evrimleşmeden oluşur. Sonuçlar Tablo 7’de verilmiştir. Değerlendirilen veri setleri boyunca üç varyant karşılaştırılabilir yeniden yapılandırma kalitesine ulaşır; standart 1 × 1 evrimleşmeli, uzaysal evrimleşmeli alternatiflere kıyasla rekabetçi bir performans sunar. Makaledeki tüm deneyler 1 × 1 evrimleşmeli dönüştürücü kullanır.
| Veri seti | Uyarlayıcı konvolüsyon | SSIM ↑ | MAE ↓ | PSNR ↑ |
|---|---|---|---|---|
| LDCT Gürültü Temizleme (karın taramaları) | Derinlik temelli 3 × 3 | 0.893 ± 0.031 | 0.035 ± 0.011 | 31.597 ± 5.163 |
| Depthwise-separable 3 × 3 | 0.899 ± 0.041 | 0.038 ± 0.018 | 29.649 ± 6.665 | |
| Conv 1 × 1 | 0.900 ± 0.090 | 0.034 ± 0.052 | 32.302 ± 6.006 | |
| LDCT Gürültü Temizleme (göğüs taramaları) | Derinlik temelli 3 × 3 | 0.500 ± 0.163 | 0.156 ± 0.045 | 19.997 ± 3.655 |
| Depthwise-separable 3 × 3 | 0.491 ± 0.159 | 0.151 ± 0.039 | 19.995 ± 3.241 | |
| Conv 1 × 1 | 0.571 ± 0.137 | 0.146 ± 0.033 | 20.192 ± 2.775 | |
| T1–T2 MRI Çevirisi (IXI) | Derinlik temelli 3 × 3 | 0.722 ± 0.037 | 0.096 ± 0.036 | 18.503 ± 0.206 |
| Depthwise-separable 3 × 3 | 0.681 ± 0.024 | 0.092 ± 0.036 | 17.405 ± 0.610 | |
| Conv 1 × 1 | 0.771 ± 0.060 | 0.088 ± 0.024 | 20.317 ± 2.275 |
Uyarlayıcı modüller içinde farklı konvolüsyon operatörleri değerlendirilmektedir; bunlar derinlik temelli 3 × 3 konvolüsyon, depthwise-separable 3 × 3 konvolüsyon ve makale boyunca kullanılan 1 × 1 konvolüsyon içerir. Her görev için en iyi sonuçlar yeşille vurgulanmıştır.
5.5 Seçmeli uyarlanmanın örnek bazlı analizi
6. şekil, önerilen seçici strateji ile TTAGrid arasında örnek düzeyinde bir karşılaştırma sunar; burada TTA, mevcut tüm yeniden inşâ modelleri ve karşılık gelen uyarlayıcılar kullanılarak her test örneğine uygular bir şekilde uygulanır. Yüzdelikler, her stratejinin SSIM, MAE ya da PSNR açısından hangi örneklerde daha iyi sonuç verdiğinin oranını gösterir; bu değerlendirme hem tüm test kümesini hem de TTAGrid’in yeniden inşâ hatası tetikleyicisiyle uyarlayıcı için seçtiği alt kümeyi kapsar. Önerilen strateji, neredeyse tüm veri kümeleri ve ölçütlerde örneklerin çoğında öne çıkar. Tüm test kümelerinde avantaj, özellikle göğüs LDCT’de belirgindir: uniform (tek tip) uyarlamaya göre SSIM, MAE ve PSNR açısından sırasıyla örneklerin %98,4’ü, %96,2’si ve %94,4’ünde daha iyi sonuç verir. Benzer tutarlı bir örüntü BraTS üzerinde de gözlemlenir; kazanma oranları %93,2 ile %96,9 arasındadır. BraTS çoğunlukla ID (kimlik içi) bir ortamı temsil ettiğinden, bu sonuçlar TTA’nın faydalı olduğuna dair kanıt olarak değil, daha çok seçici uyarlamanın her örneği ve her özellik seviyesini uyarlamanın yol açtığı bozulmayı sınırladığına işaret etmelidir. Dışsal OOD (kimlik dışı) alanını temsil eden IXI’de de TTAGrid, uniform uyarlamayı geride bırakır; tüm test kümesinde SSIM, MAE ve PSNR için sırasıyla %68,6, %71,8 ve %84,5 kazanır. Tetikleyiciyle seçilen alt kümede avantajı daha da belirginleşir; karşılık kazanma oranları %76,0, %71,5 ve %87,0’a yükselir. Genel olarak, tetikleyiciyle seçilen kümelerdeki sonuçlar, uyarlamaya muhtaç örnekleri belirlemenin tek başına yeterli olmadığını gösterir: uyarlayıcı yapılandırmasını dinamik olarak seçmek, tüm uyarlayıcıları aktive etmeye karşı genellikle değerlendirilen ölçütlerde %60’ın üzerinde kazanma oranlarıyla avantajlıdır. Başlıca istisna, göğüs LDCT tetikleyiciyle seçilen alt kümesindeki SSIM’dir; burada tam yapılandırma örneklerin %65,9’unda kazanır ve bu da daha geniş özellik değişikliğinin bu özel alt kümede benzerlik benzerliğinden (SSIM) faydalanabileceğine işaret eder. Önerilen yöntem yine de aynı örneklerde MAE ve PSNR için daha iyi sonuç verir ve görevler boyunca belirgin bir avantaj gösterir. Bu bulgular, çerçevenin birbirini tamamlayan iki bileşenini destekler:
reconstruction hatası eşiği gereksiz uyarlamayı önlerken, grid araması her tetikleyiciyle seçilen örnek için uyarlanacak özellik seviyelerini seçerek sabit, tek boyuta uyarlanan bir dönüşümden kaçınır.
5.6 Reconstruction hatası ve çeviri kalitesi
Reconstruction hatasının örneğe özgü çeviri uyumsuzluğunun bilgilendirici bir sinyomi olup olmadığını daha derinlemesine incelemek için, karaciğer LDCT test kümesinin tetikleyiciyle seçilen B⊂A alt kümesi içinde farklı reconstruction hatası seviyeleri boyunca çeviri kalitesini analiz ederiz. B kümesindeki örnekler, reconstruction hataları ϵy temel alınarak beş beşteyike ayrılır.
Şekil 7’de görüldüğü gibi, artan reconstruction hatası, art arda bozulan temel çeviri kalitesi ile ilişkilidir. TTA’dan önce, daha yüksek reconstruction hatası beşteyiklerine ait örnekler daha düşük SSIM ve PSNR değerleri ve daha yüksek MAE değerleri gösterir. Spesifik olarak SSIM, ilk beşteyikte yaklaşık 0.84’ten beşinci beşteyikte 0.70’e düşerken, PSNR yaklaşık 20.1’den 17.5 dB’e ve MAE yaklaşık 0.064’ten 0.112’ye artar.
TTA’dan sonra çeviri kalitesi, tüm reconstruction hatası beşteyiklerinde iyileşir. Uyarlamadan elde edilen fayda genellikle reconstruction hatasıyla birlikte artar; daha büyük reconstruction hatalarıyla karakterize edilen örnekler daha büyük iyileşmeler elde eder. SSIM kazancı, ilk beşteyikte yaklaşık +0.08’den beşinci beşteyikte +0.22’ye artarken, PSNR iyileşmesi yaklaşık +10.9’dan +16.28 dB’e artar. Bu eğilimler, reconstruction hatasının dağılım kaymasının etkisi için örneğe düzeyinde bir vekil (proxy) sağladığını gösterir; çünkü daha yüksek değerler, uyarlamadan önce daha büyük çeviri bozulması ve TTA’dan daha büyük potansiyel kazançla ilişkilidir.
5.7 Örnek bilinçli TTA için alternatif arama stratejileri
TTAGrid’in hesaplama yükünü azaltmak için, örnek bilinir adaptör seçiminde alternatif arama stratejileri inceliyoruz; bu stratejiler yapılandırma alanı Ω üzerinde gezinme biçimlerinde birbirinden ayrılır. Tablo 8’de özetlendiği gibi, rastgele, açgözlü ve olasılıksal arama paradigmalarını içeren tüketici olmayan beş strateji değerlendiriyoruz. Özellikle TTAR10 ve TTAR50, sırasıyla 10 ve 50 örneklenen yapılandırma değerlendirerek rastgele aramayı gerçekleştirir. TTAFS ve TTABE, açgözlü ileri seçim ve geri eleme prosedürlerini benimserken, TTABA yapılandırma alanının gezinmesini yönlendirmek için Bayesçi optimizasyonu kullanır. Tablo 8’in son sütunu, karşılık gelen kuramsal karmaşıklığı bildirir; bu, görev-modeli katmanlarının sayısı n ve gezinilen yapılandırma sayısı Nconfig fonksiyonu olarak ifade edilir. Ayrıca tablo, yapılandırma arama aşamasının getirdiği pratik hesaplama yükünü nicelendirmek için, üç değerlendirilen veri setinden tüm tetiklenen örnekler üzerinden hesaplanan, her arama stratejisi için tetiklenen örnek başına ortalı TTA uyarlama süresini de bildirir.
| Deney | Açıklama | Zaman (s/örnek) | |
|---|---|---|---|
| TTAGrid | Tüm adaptör yapılandırmaları üzerinde tüketici arama. | 86.47 | |
| TTAR10 | 10 örneklenen yapılandırma ile rastgele arama. | 8.48 | |
| TTAR50 | 50 örneklenen yapılandırma ile rastgele arama. | 44.20 | |
| TTAFS | Adaptör yapılandırmalarının açgözlü ileri seçimi. | 24.42 | |
| TTABE | Adaptör yapılandırmalarının açgözlü geri elemesi. | 23.79 | |
| TTABA | Adaptör yapılandırmaları üzerinde Bayesçi yönlendirmeli arama. | 33.39 |
Son iki sütun, üç değerlendirilen veri seti üzerinde tetiklenen örnek başına ortalı uyarlama süresini ve kuramsal karmaşıklığı bildirir; burada n görev modelindeki katman toplam sayısı, n−2 ara katmanlar ve Nkonfig ise keşfedilen yapılandırma sayısıdır.
Tablo 9, Tablo 4 ile aynı biçimde nicelsel sonuçları bildirir. BraTS 2018 üzerindeki sonuçlar atlanır, çünkü önceki analiz TTA’nın bu ID ortamında performansı iyileştirmediğini göstermiş; bu nedenle ek arama stratejilerinin değerlendirilmesi gereksizdir. Sonuçlar üç bölüme ayrılmıştır: karın taranmalarında LDCT gürültü temizleme, göğüs taranmalarında LDCT gürültü temizleme ve IXI üzerinde T1’den T2’ye çeviri. Her ortamda performans hem tüm test seti A hem de tetiklemeyle seçilen alt küme B⊂A üzerinde bildirilir.
| Görev | Denej | SSIM ↑ | MAE ↓ | PSNR ↑ | |||
|---|---|---|---|---|---|---|---|
| A | B⊂A | A | B⊂A | A | B⊂A |
| LDCT Gürültü Temizleme (karın taranmaları) | TTAGrid | 0.926 ± 0.034 | 0.900 ± 0.090 | 0.037 ± 0.020 | 0.034 ± 0.052 | 32.043 ± 3.657 | 32.302 ± 6.006 |
| TTAR10 | 0.899 ± 0.090 | 0.916 ± 0.038 | 0.035 ± 0.052 | 0.042 ± 0.022 | 32.190 ± 6.025 | 30.723 ± 3.726 |
| TTAR50 | 0.899 ± 0.091 | 0.918 ± 0.042 | 0.034 ± 0.052 | 0.041 ± 0.023 | 32.235 ± 6.020 | 31.252 ± 3.803 |
| TTAFS | 0.898 ± 0.091 | 0.901 ± 0.061 | 0.035 ± 0.052 | 0.046 ± 0.028 | 32.084 ± 6.111 | 29.482 ± 4.581 |
| TTABE | 0.899 ± 0.091 | 0.912 ± 0.047 | 0.035 ± 0.052 | 0.044 ± 0.025 | 32.174 ± 6.062 | 30.535 ± 4.312 |
| TTABA | 0.896 ±0.092 | 0.876 ± 0.069 | 0.036 ± 0.054 | 0.063 ± 0.051 | 31.930 ± 6.193 | 27.678 ± 4.536 |
| LDCT Gürültü Temizleme (akciğer taramaları) | TTAGrid | 0.661 ± 0.101 | 0.571 ± 0.137 | 0.081 ± 0.022 | 0.146 ± 0.033 | 25.444 ± 2.194 | 20.192 ± 2.775 |
| TTAR10 | 0.541 ± 0.101 | 0.268 ± 0.136 | 0.081 ± 0.022 | 0.150 ± 0.031 | 25.439 ± 2.203 | 19.921 ± 2.576 |
| TTAR50 | 0.541 ± 0.101 | 0.273 ± 0.137 | 0.081 ± 0.022 | 0.146 ± 0.033 | 25.446 ± 2.190 | 20.268 ± 2.756 |
| TTAFS | 0.540 ± 0.103 | 0.249 ± 0.158 | 0.082 ± 0.030 | 0.205 ± 0.102 | 25.399 ± 2.382 | 18.022 ±4.598 |
| TTABE | 0.541 ± 0.101 | 0.272 ± 0.138 | 0.081 ± 0.023 | 0.155 ± 0.049 | 25.437 ± 2.219 | 19.852 ± 3.050 |
| TTABA | 0.541 ±0.101 | 0.268 ± 0.136 | 0.082 ± 0.027 | 0.164 ± 0.101 | 25.432 ± 2.232 | 19.597 ± 3.009 |
| MRI T1-T2 (IXI) | TTAGrid | 0.739 ± 0.068 | 0.771 ± 0.060 | 0.093 ± .022 | 0.088 ± .024 | 20.042 ± 1.968 | 20.317 ± 2.275 |
| TTAR10 | 0.729 ± 0.060 | 0.760 ± 0.048 | 0.088 ± 0.022 | 0.081 ± 0.022 | 19.303 ± 2.328 | 19.447 ± 1.946 |
| TTAR50 | 0.727 ± 0.063 | 0.758 ± 0.056 | 0.089 ± 0.021 | 0.082 ± 0.022 | 19.676 ± 1.899 | 19.678 ± 2.275 |
| TTAFS | 0.716 ± 0.059 | 0.740 ± 0.057 | 0.099 ± 0.021 | 0.100 ± 0.024 | 18.850 ± 1.834 | 18.325 ± 2.019 |
| TTABE | 0.728 ± 0.060 | 0.759 ± 0.050 | 0.090 ± 0.020 | 0.083 ± 0.020 | 19.435 ± 2.022 | 19.284 ± 2.430 |
| TTABA | 0.721 ± 0.054 | 0.747 ± 0.045 | 0.094 ±0.021 | 0.091 ±0.024 | 18.925 ±1.853 | 18.448 ± 2.077 |
Ölçümler tüm test kümesi A ve B ? A alt kümesi için bildirilmektedir. Her görev için en iyi sonuçlar yeşille, ikinci en iyi sonuçlar maviyle işaretlenmiştir. Bir asterisk () işareti, varyansı azaltmak ve kararlılığı artırmak için sonuçların üç çalıştırma üzerinden ortalamasının alındığını göstermektedir.
Abdominal LDCT taramalarında TTAGrid, ölçümler arasında en dengeli performansı göstererek A üzerinde en yüksek SSIM ve B üzerinde en iyi MAE ile PSNR elde etmektedir. Bununla birlikte, TTAR50 rekabetçi kalmakta, B üzerinde en yüksek SSIM ve A üzerinde en düşük MAE sağlamaktadır. Arama stratejileri arasındaki farklar her zaman istatistiksel olarak anlamlı değildir; özellikle TTAR50 ile karşılaştırmada bu durum öyle olup, tamamlayıcı malzeme—Ek B’de ayrıntılı olarak verilmiştir.
Benzer bir ödünleşim, görünmeyen anatomik alanı temsil eden göğüs taramalarında da ortaya çıkmaktadır. Burada TTAGrid hem A hem de B üzerinde en yüksek SSIM elde ederken, TTAR50 en yüksek PSNR sağlamakta ve B üzerinde en iyi MAE’ye ulaşmaktadır. Bu iki strateji arasındaki farklar hiçbir ölçümde istatistiksel olarak anlamlı bulunmamıştır; tamamlayıcı malzeme—Ek B’de ayrıntılı olarak verilmiştir.
IXI üzerinde TTAGrid hem A hem de B üzerinde en yüksek SSIM ve PSNR elde ederken, TTAR10 en düşük MAE sağlamaktadır. Arama stratejileri arasındaki farklar her zaman istatistiksel olarak anlamlı değildir; özellikle TTAR50 ile karşılaştırmada bu durum öyle olup, tamamlayıcı malzeme—Ek B’de ayrıntılı olarak verilmiştir.
Bu bulgular, tüketici arama (exhaustive search)’ın veri setleri ve metrikler açısından TTAR50’ye karşı tutarlı bir istatistiksel avantaj sağlamadığını göstermektedir. Rastgele arama, daha az konfigürasyon keşfederek adaptasyon kalitesini korurken, performans ile hesaplama maliyeti arasında daha elverişli bir denge sunar.
5.8 Hesaplama analizi
Şekil 8, önerilen TTA arama stratejilerinin üç değerlendirme veri seti üzerindeki verimlilik–performans dengesini göstermektedir. x-ekseni, her arama stratejisinin gerektirdiği GFLOPs değerini logaritmik ölçek üzerinde bildirirken, y-ekseni tetikleyici tarafından seçilen alt küme B⊂A üzerinde elde edilen PSNR değerini göstermektedir.
TTAGrid, tüm konfigürasyon uzayını eksiksiz değerlendirerek en yüksek yeniden inşa kalitesine ulaşır, ancak aynı zamanda en yüksek hesaplama maliyetini de karşılar. Eksiksiz olmayan arama stratejileri arasında, TTAR50, değerlendirilen konfigürasyon sayısı ve buna bağlı GFLOPs değerini azaltırken ızgaralı aramaya en yakın performansı sağlar. TTAR10, PSNR’de orta düzeyde bir azalma ile hesaplama maliyetini daha da düşürür. Seçime dayalı stratejiler olan TTAFS, TTABE ve TTABA, arama yükünü azaltırken eksiksiz değerlendirmenin sağladığı performansın önemli bir bölümünü koruyarak ara düzeyde bir verimlilik–performans dengesini sunar.
Baloncuk grafiği, yaklaşıklık temeli arama stratejilerinin, özellikle TTA her test örneği için ayrı ayrı yapıldığında, eksiksiz değerlendirmeye göre daha elverişli bir verimlilik–performans dengesini sağlayabileceğini vurgulamaktadır. Tablo 8’de bildirilen duvar saati süreleri, yeniden-inşa hatası tetikleyicisi tarafından seçilen örnekler için adaptasyon aşamasına aittir.
6 Sonuçlar
Örnek bilinçli bir TTA çerçevesi tıbbi görüntüden görüntüye çeviri için sunduk. Çerçeve, uyarlamayı aktarmayı aktarmayı belirleyen bir yeniden yapılandırma hatası tetikleyicisi ile giriş düzeyinde bir dönüştürücü ve her test örneği için değiştirilecek ara özellik seviyelerini seçen dinamik bir uyarlama bloğunu birleştiriyor. Önceden eğitilen görev modeli uyarlama boyunca donuk kalıyor; bu da çerçevenin hem uyarlamanın gerekip gerekmediğini hem de orijinal model parametreleri güncellenmeden hangi iç temsillerin değiştirileceğini belirlemesini sağlıyor.
Mayo Klinik veri setinde LDCT gürültü temizleme ve BraTS 2018 ile IXI üzerinde T1-to-T2 MRI çevirisi deneyimleri, TTA faydasının test dağılımına bağlı olduğunu gösteriyor. TTAGrid, karın LDCT’si, anatomik olarak kaydırılmış akciğer CT’si ve dış IXI test setinde en iyi bildirilen SSIM, MAE ve PSNR değerlerine ulaşıyor. BraTS 2018 üzerinde ise uyarlama, tahminleri zaten yüksek çeviri kalitesine ulaşan donuk görev modeline kıyasla ölçülebilir bir iyileşme sağlamıyor. Bu sonuç, seçici aktivasyon desteğini gösteriyor: uyarlama, test örnekleri görev modelini etkileyen yönlerde kaynak veriden farklılaştığında en yararlı oluyor.
SPA ve TTAGrid aynı yeniden yapılandırma hatası tetikleyicisini ancak farklı uyarlama mekanizmalarını kullanıyor. Karşılaştırmaları, yalnızca örnek seçiminin yeterli olmadığını; uyarlama işleminin aynı zamanda hangi iç özellik seviyelerinin değiştirileceğini ve her bireysel giriş için bunların nasıl dönüştürüleceğini de belirlemesi gerektiğini gösteriyor. İnceleme deneyleri bu yorumu destekliyor: örnek özgü dönüştürücü seçimi, sabit aktivasyon kalıplarıyla karşılaştırıldığında yeniden yapılandırma kalitesini iyileştiriyor ya da koruyor; dönüştürücü içindeki konvolüsyonel operatör seçimi ise nispeten sınırlı bir etkiye sahip. Bu, uyarlamanın nerede ve ne zaman uygulanmasının, dönüştürücünün kendisinin mimari karmaşıklığını artırmaktan daha etkili olduğunu öne sürüyor.
Örnekle analiz, rastgele uyarlamaya karşı ek kanıt sunar. Seçici, örneğe özgü uyarlama; anatomik ve dış-alan kaymalarının yaşandığı durumlar dahil olmak üzere değerlendirilen örneklerin ve ölçütlerin çoğında, mevcut tüm uyarlayıcıların düz aktivasyonundan daha iyi performans gösterir. Kimlik BraTS ortamında ise temel avantajı, gereksiz uyarlamadan kaynaklanan bozulmayı sınırlamaktır. Yeniden inşa hatası ile çeviri kalitesi arasındaki ilişkiyle birlikte bu bulgular, yeniden inşa hatasının, her test örneğinin nasıl ve uyarlamanın gerekip gerekmediğine dair faydalı bir sinyal sağlayabileceğini düşündürmektedir.
Gelenekli görüntü kalitesi ölçütlerinden elde edilen sonuçlar, temel-model tabanlı algısal değerlendirmeler tarafından da desteklenmektedir. LDCT ve IXI’de uyarlama, MedDINOv3 ve DINOv3 tarafından çıkarılan hem küresel hem de yoğun temsil edilmiş özelliklerde, oluşturulan ve referans görüntüler arasındaki benzerliği artırırken; BraTS 2018’de buna karşılık gelen bir fayda gözlemlenmemiştir. Pikel düzeyindeki ve temsil düzeyindeki değerlendirmeler arasındaki bu uyum, önerilen uyarlamanın yalnızca yerel yeniden inşa ölçütlerini optimize etmekle kalmayıp, dağılım kaydının altında üst düzey görüntü temellerinin tutarlılığını da iyileştirebileceğini göstermektedir.
Hesaplama açısından TTAGrid’in gerçekleştirdiği kapsamlı arama, örnek-özel uyarlama yapılandırmalarını belirlemek için etkili bir referans stratejisi sunar; ancak maliyeti, aday ara aralama seviyelerinin sayısı ile üstel olarak artar. Alternatif arama stratejilerinin değerlendirmesi, bu hesaplama yükünün önemli ölçüde azılabileceğini göstermektedir. Özellikle rastlantısal arama varyantları, yapılandırma uzayının yalnızca bir alt kümesini keşfederken birkaç durumda karşılaştırılabilir bir çeviri kalitesi sağlar; oysa açgözlü ve Bayesçi stratejiler, farklı verimlilik-performans ödünleşimleriyle ek alternatifler sunar. Bu sonuçlar, kapsamlı aramanın her dağıtım senaryosunda gerekli olmadığını ve önerilen çerçevenin, çıkarım gecikmesi veya hesaplama kaynakları sınırlı olduğunda daha hafif yapılandırma seçim mekanizmalarını karşılayabileceğini göstermektedir.
Önerilen çerçeve bir dizi yönle genişletilebilir. Mevcut tetikleyici, kaynak alanı yeniden inşâ hatası dağılımının sabit bir yüzdeliğini kullanır. Bu seçim, kaymış test kümelerinden istatistik erişimi olmadan aralamayı mümkün kılarken, aynı zamanda basit ve tekrarlanabilir bir aktivasyon kuralı sağlar. Gelecek çalışmalar, çeviri görevini, model mimarisini ve dağılım kayması türünü dikkate alan uyarlanabilir kalibrasyon, belirsizlik-odaklı eşikler ve öğrenilen tetikleme kriterlerini inceleyebilir. Bu yaklaşımlar, kaynak alanı temsilleriyle uyumluluğu ölçen ancak kullanılamayan hedef görüntüyle doğrudan karşılıklı eşlemeyi ölçmeyen yeniden inşâ hatasını tamamlayabilir.
Konfigürasyon araması ayrıca daha fazla optimizasyon için olanak sunar. Kapsamlı değerlendirme, örnek bazında detaylı seçim sağlar; ancak maliyeti, aday özellik seviyesi sayısı ile üstel olarak artar. Rastgele, açgözlü ve Bayesçi stratejilerle elde edilen sonuçlar, arama alanının daha az aday değerlendirmesiyle gezilebileceğini göstermektedir. Öğrenilen seçiciler, amortize konfigürasyon tahmini ve erken budama işlemleri, örnek bazında uyarlanmanın sağladığı avantajları korurken gecikmeyi daha da azaltabilir. Çerçevenin modüler yapısı, aynı zamanda mevcut deney ayarının ötesine uzanmayı destekler. Ancak güncel çalışma, tam mimari bağımsız genelleştirmeyi kanıtlamayı amaçlamaz. Güncel doğrulama, bir CycleGAN omurgası, iki çeviri görevi ve bireysel iki boyutlu dilimler üzerine dayanır. Çerçevenin koşullu GAN’lar, dönüştürücü tabanlı üreticiler ve yayılım modelleri gibi alternatif üretici mimarilere genişletilmesi, adaptör yerleştirmesi, özellik temsilleri ve yeniden inşaa modülleri gibi mimariye bağlı bileşenlerin uyarlanmasını gerektirebilir. Gelecek değerlendirmeler, bu genişletmeleri ek anatomik bölgeler, edinim protokolleri, bağımsız klinik kohortlar ve üç boyutlu mimariler üzerinde inceleyerek hacimsel bağlamdan yararlanabilir ve komşu dilimler arasında tutarlılığı artırabilir.
Önerilen çerçeve, aktivasyon ve özellik değişikliğini örnek bazında belirleyen bir TTA stratejisi ortaya koyar. Sonuçlar, bu ayrımın anatomik ve dış-alan kaymaları altında çeviri kalitesini artırabileceğini, ancak tüm test girdilerini örneklemeden değiştirmekten kaçınabileceğini göstermektedir. Örnek bilgilendirili aktivasyon ve konfigürasyon seçimi, dolayısıyla daha uyumlu ve hesaplama verimli tıbbi görüntü çeviri sistemlerinin geliştirilmesi için pratik bir temel sağlar.
Açıklamalar
Veri erişilebilirliği açıklaması
Çalışmada sunulan özgün katkılar makaleye/Ek malzemeye dahil edilmiştir; daha ileri yönlendirmeler ilgili yazar ile yapılabilir.
Yazar katkıları
II: Kavramlaştırma, Veri düzenleme, Biçimsel analiz, Araştırma, Metodoloji, Yazılım, Doğrulama, Görselleştirme, Yazım – taslak, Yazım – inceleme & düzenleme. FD: Kavramlaştırma, Veri düzenleme, Biçimsel analiz, Araştırma, Metodoloji, Yazılım, Yönetim, Görselleştirme, Yazım – taslak, Yazım – inceleme & düzenleme. MT: Kavramlaştırma, Biçimsel analiz, Metodoloji, Yönetim, Yazım – inceleme & düzenleme. RS: Kavramlaştırma, Biçimsel analiz, Metodoloji, Yönetim, Yazım – inceleme & düzenleme. VG: Kavramlaştırma, Biçimsel analiz, Metodoloji, Yönetim, Yazım – inceleme & düzenleme. PS: Kavramlaştırma, Biçimsel analiz, Finansman edinme, Araştırma, Metodoloji, Kaynaklar, Yönetim, Yazım – inceleme & düzenleme.
Tesekkürler
Irene Iele, Roma Campus Bio-Medico Üniversitesi tarafından düzenlenen Sağlık ve Yaşam Bilimleri dersi kapsamında Ulusal Yapay Zekâ Doktora Programı (XL dönemi) altında kayıtlı bir doktora öğrencisidir. Kaynaklar, İsveç Araştırma Kurumu’nun 2022-06725 ve 2018-05973 numaralı anlaşmalar yoluyla kısmen finanse ettiği İsveç Ulusal Süper Bilgiseyaltyatay Altyapısı (NAISS) ve Alvis @ C3SE altında İsveç Ulusal Bilgisalama Altyapısı (SNIC) tarafından sağlanmaktadır.
Çıkar çatışması
Yazar(lar), bu çalışmanın ticari veya olası bir çıkar çatışması olarak değerlendirilebilecek herhangi bir finansal ilişkinin olmadığı koşullarda yürütüldüğünü beyan etmiştir.
Üretken yapay zekâ beyanı
Yazar(lar), bu metnin oluşturulmasında Üretken Yapay Zekâ kullanılmadığını beyan etmiştir.
Bu makaledeki figürlerle birlikte sağlanan alternatif metinler (alt text), Frontiers tarafından yapay zekâ desteğiyle oluşturulmuş olup, mümkün olduğunca yazarların incelemesini de içeren doğruluğu sağlamak için makul çabalar gösterilmiştir. Herhangi bir sorunu tespit ederseniz, lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm görüşler yalnızca yazarların görüşleridir ve bağlı oldukları kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini zorunlu olarak yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
Ek malzeme
Bu makalenin Ek Malzemesi çevrimiçi olarak şu adreste bulunabilir: https://www.frontiersin.org/articles/10.3389/frai.2026.1953730/full#supplementary-material
Özet
Anhtar kelimeler
alan kayması, tıbbi görüntü çevirisi, tıbbi görüntüleme, seçici uyarlama, test-zamanında uyarlama
Atıf
Iele I, Di Feola F, Tortora M, Sicilia R, Guarrasi V ve Soda P (2026) Sample-aware test-time adaptation for medical image-to-image translation. Front. Artif. Intell. 9:1953730. doi: 10.3389/frai.2026.1953730
Makale teslim tarihi
30 Temmuz 2026
Düzeltilme tarihi
7 Ekim 2026
Kabul tarihi
14 Ekim 2026
Yayınlanma tarihi
12 Kasım 2026
Cilt
9 – 2026
Wei Li, Chongqing Üniversitesi, Çin
Yuan Qiu, Singapore Teknoloji Enstitüsü, Singapur
Arthur Longuefosse, RIKEN Entegratif Tıp Bilimleri Merkezi, Japonya
© 2026 Iele, Di Feola, Tortora, Sicilia, Guarrasi ve Soda.
Bu, Creative Commons Atıf Lisansı (CC BY) koşulları altında dağıtılan açık erişimli bir makaledir. Kabul edilen akademik uygulama uygun şekilde, orijinal yazar(lar)ın ve telif hakkı sahibin(lerin) isminin verilmesi ve bu dergideki orijinal yayının atıf edilmesi şartıyla, bu makalenin başka forumlarda kullanımı, dağıtımı veya çoğaltılması mümkündür. Bu koşullara uymayan herhangi bir kullanım, dağıtım veya çoğaltmaya izin verilmez.
*İletişim: Francesco Di Feola, francesco.feola@umu.se
†
Bu yazarlar bu çalışmaya eşit katkıda bulunmuş ve ilk yazarlığı paylaşmaktadır
Bu makalede ifade edilen tüm görüşler yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, yayıncının, editörlerin ya da hakemlerin görüşlerini zorunlu olarak yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün ya da üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti altına alınmaz ya da desteklenmez.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔




İlk yorumu siz yazın
Fikrinizi bir kaynak, soru veya yapıcı karşı görüşle geliştirin.